AI 编程 Agent 真正难的,不是生成一段代码,而是在真实仓库里跨会话完成任务、验证结果,并留下下一次可以继续工作的状态。
最近一年,模型写代码的能力提升得很快。补一个函数、生成一个页面、解释一段报错,已经不再稀奇。
但把任务放进真实项目,问题很快就会暴露出来:它可能没有先读项目规则,改了不该动的文件;可能写完代码却没有跑测试;也可能在上下文越来越长以后忘记原来的目标,最后用一句“已经完成”结束任务。
这类失败不一定是模型不够聪明,更常见的原因是:模型周围缺少一套可靠的工作系统。
这正是开源项目 Learn Harness Engineering 想解决的问题。
Harness Engineering 不是“再写一份更长的提示词”
Harness 可以理解为套在模型外面的工程环境。模型负责推理和生成,Harness 负责规定它在什么范围内工作、从哪里读取事实、如何保存状态、用什么方式验证,以及什么时候才允许宣布完成。
项目 README 把这套工作环境拆成五个可以操作的子系统。
一、Instructions:指令。
用 AGENTS.md、项目文档和功能清单告诉 Agent:开始前要读什么,允许改什么,按什么顺序做,完成标准是什么。重点不是把所有规则塞进一个超长文件,而是让 Agent 能按需找到正确的信息。
二、State:状态。
把进度、未完成事项、验证结果和 Git 历史保存在仓库里。这样即使换了会话,下一次也不必依赖模型“记住上次聊了什么”。
三、Verification:验证。
测试、Lint、类型检查、冒烟运行和页面回读才是完成证据。代码看起来合理,和代码真的能工作,是两件不同的事。
四、Scope:范围。
一次只处理一个有明确边界的功能,避免 Agent 同时铺开多个方向,最后留下三份都没收尾的半成品。
五、Session Lifecycle:会话生命周期。
开始时初始化环境,结束时清理状态、记录交接信息,并确保下一个会话有一条可恢复的路径。
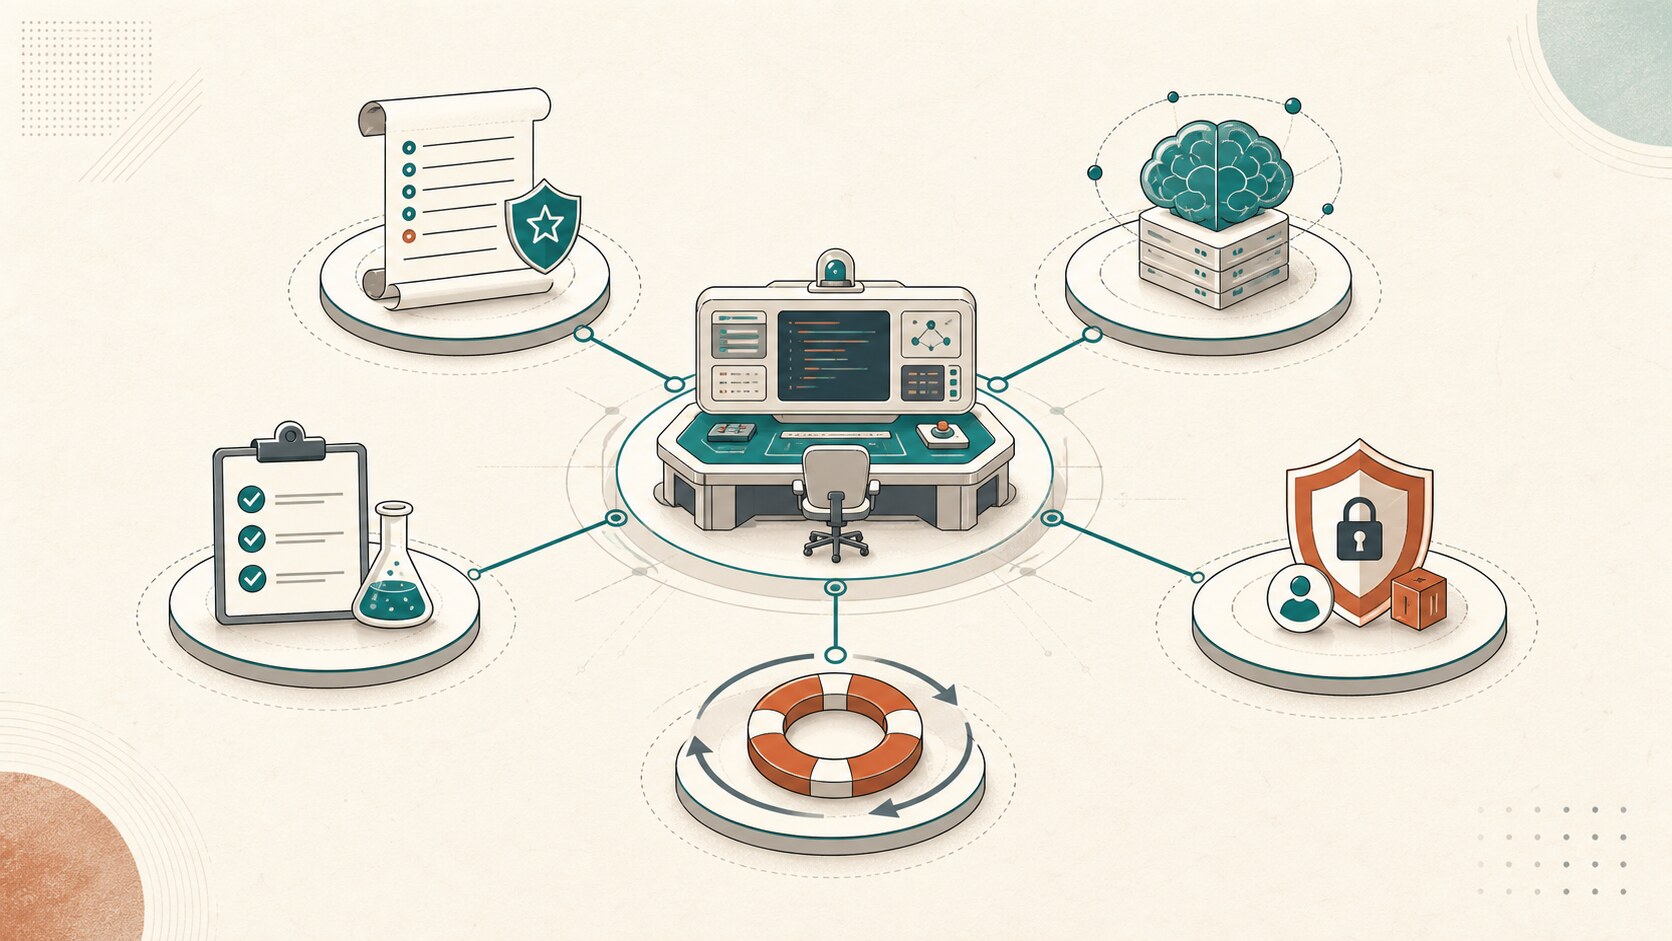
把这五部分连起来以后,Agent 的工作方式会从“收到一句话就开始写”变成一个闭环:
读取规则 → 初始化环境 → 完成一个范围明确的任务
      ↑                         ↓
恢复状态 ← 留下交接记录 ← 验证、修正、再验证
Harness 不会让模型突然变得更聪明,但它会让模型更难跳过关键步骤。
这个项目最有价值的地方,是让你亲手做对比实验
Learn Harness Engineering 不是只有概念文章。当前主线提供 14 讲、8 个递进实践、15 种语言版本和一套可复制的资源模板,使用 MIT License 开源。
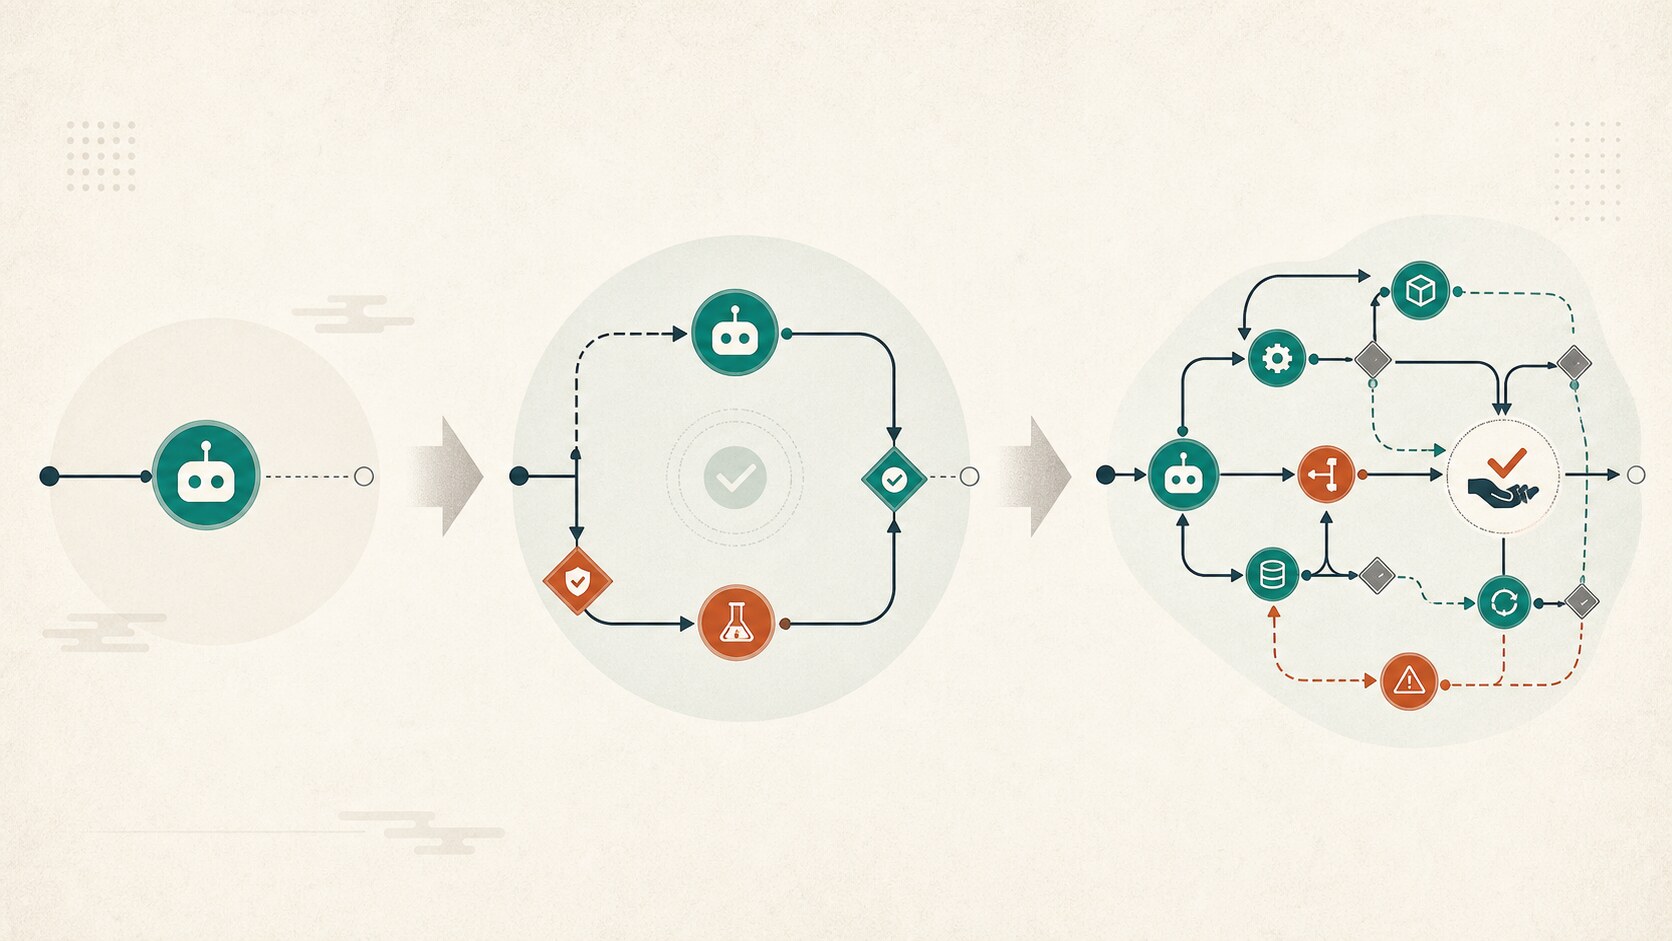
它的学习顺序很像搭建一条逐步加固的工程流水线。
第一阶段:先看见差异
Project 01 让你用同一个任务比较“纯提示词驱动”和“最小 Harness 驱动”。
这一步很重要。没有基线,就很容易把“感觉更专业”误当成“结果更可靠”。你需要实际记录完成率、人工介入次数、返工次数和验证结果。
第二阶段:让仓库可以被 Agent 持续接手
接下来的实践逐步加入 Agent 可读的仓库结构、跨会话状态、运行反馈、独立验证和可观测性。
你会开始处理真实工程里最常见的几个问题:下一次会话如何接住上一次工作;失败以后如何定位到具体环节;实现者是否应该同时担任评审者;怎样避免“测试没跑,但任务已经被标成完成”。
第三阶段:从单次执行走向自动循环
Project 07 进入 Loop Engineering。它让你分别体验 Goal Loop、Timer Loop 和 Maker-Checker Loop。
其中最值得做的是 Maker-Checker:一个 Agent 负责实现,另一个 Agent 按独立标准检查,状态文件记录每一轮结果,停止条件决定循环什么时候结束。人不再需要盯住每一步,但仍然掌握目标、预算和退出权。
第四阶段:当循环变复杂,把它画成图
Project 08 继续走向 Graph Engineering:显式写出节点、边、共享状态和路由规则,再加入并行分支、条件回退和人工审批节点。
这一步不是鼓励所有任务都上复杂编排。相反,它帮助你判断:什么时候一个简单循环已经不够,什么时候并行和审批带来的价值能够覆盖协调成本。
它还拆了四种真实 Harness 设计
课程新增了“前沿 Harness 拆解”,用统一框架分析 Pi、Claude Code、Codex 和 DeepSeek Harness。
这部分的价值不在于比较谁的模型更强,而在于观察不同团队怎样处理同一类工程问题:
- Pi 选择极简内核和可编程扩展;
- Claude Code 强调分层记忆、压缩、权限、钩子与子 Agent;
- Codex 把仓库作为事实来源,并用
AGENTS.md和 worktree 管理信息与隔离; - DeepSeek Harness 采用 “Everything is a Plugin” 的运行时思路。
先学课程框架,再看这些真实实现,会比单独背某个工具的命令更容易迁移。
如果只用两小时,我建议这样开始
前 30 分钟:读第一讲和第二讲,先弄清楚“模型能力”和“执行可靠性”为什么不是同一个问题。
接下来 60 分钟:完成 Project 01。选一个足够小、可以重复验证的真实任务,用相同模型和相同需求分别跑一次无 Harness 基线和最小 Harness 版本。
最后 30 分钟:只把四样东西带回自己的仓库:
- 一份简短的
AGENTS.md; - 一份可检查的功能或任务清单;
- 一个统一的初始化入口;
- 一条机器可以执行的验证命令。
不要一开始就照搬完整模板。先证明这四样东西能降低返工,再逐步加入状态交接、独立评审、循环和图。
学习时不要只看“代码有没有生成”
判断 Harness 是否有效,至少记录下面五个指标:
- 任务完成率:验收标准是否真的全部通过;
- 人工介入次数:中途需要人纠偏多少次;
- 错误完成率:Agent 宣布完成,但验证没有通过的次数;
- 返工量:为了修复越界修改或遗漏步骤,需要重做多少;
- 恢复时间:换一个新会话以后,多久能准确继续上次工作。
如果这些指标没有改善,文件再齐全,也只是“看起来像 Harness”。
谁适合学,谁可以先不学
如果你经常让 Codex、Claude Code、Cursor 或其他 Agent 修改真实仓库;任务会跨多个会话;项目有测试、部署或安全边界;或者你正在设计自动循环,这套课程值得系统做一遍。
如果你只是偶尔生成一段一次性脚本,先掌握清晰提问和基本代码审查就够了。完整 Harness 也有维护成本,不是文件越多越专业。
还要注意:这是一套快速更新的开源课程,不是装上就能保证生产交付的框架。仓库当前顶部信息和具体目录已经更新到 14 讲、8 个实践,个别概览页仍可能保留旧数字。学习时应以主分支目录和具体项目页为准。
最后
AI 编程进入工程阶段以后,真正稀缺的能力正在发生变化。
过去我们关心“模型能不能写出这段代码”;现在更应该关心“它能不能在正确边界内持续工作,并用证据证明结果”。
Prompt 决定一次回答从哪里出发,Harness 决定一项工程怎样走到可以验收的终点。
如果你已经在真实项目里使用 AI Coding Agent,这个开源项目最值得做的,不是收藏,而是从 Project 01 开始,亲手跑一次对比。
开源仓库:https://github.com/walkinglabs/learn-harness-engineering
在线课程:https://walkinglabs.github.io/learn-harness-engineering/zh/
开源协议:MIT License
资料核对:本文依据该仓库 main 分支截至 2026-08-20 的 README、中文课程目录和项目文档整理;课程仍在持续更新。