接口排错往往需要几轮检查:读取日志和代码、定位调用关系、修改、运行测试,再打开页面确认。材料逐轮积累后,长历史的计算成本和任务状态能否恢复,都会影响交付。
本文一起讨论 V4.1-Flash 与 Harness 0.1.5。模型侧减少处理长历史的开销,Harness 侧改进材料接收、工具调用、会话恢复和文件交付。两边配合后,才有条件比较一项工作能否更省地完成。
对于经常把代码、文档和截图一起交给 AI 的开发者,这轮升级值得试。 短问答未必能充分体现它的变化,跨几个文件、要反复调用工具的任务更合适。
本文保留 2026 年 9 月 11 日 的资料口径,依据官方技术报告、价格页与发布源码。文中的「最新」指当时的 dsh-v0.1.5-rc.2,仍为开发者预览。分数来自厂商评测,未进行项目对照实测;价格与模型路由也不是今天重新核验的结果。12
Agent 评测提升,还要看配套工具配置
V4.1-Flash 的进步,在 Agent 任务上尤其明显。官方公布的 DeepSWE v1.1 成绩从前代 Flash 的 54.4 提升到 74.2;这组测试关注模型能否解决真实仓库里的软件问题。Terminal-Bench 2.1 则从 82.7 到 90.6,主要看终端环境下的任务完成能力。1
这些结果支持重新试用开发任务,但需要保留配置:74.2 使用 mini-SWE,90.6 使用 DSH Minimal,均采用最大推理 effort。默认聊天窗口并不自动具有相同工具和运行条件。
报告里还有一组更能说明问题的对比:同一个 V4.1-Flash,在 DeepSWE 上搭配 OpenCode 得到 65.5,DSH Minimal 是 72.6,mini-SWE 是 74.2。模型没有换,外面的提示词、工具与执行方式换了,结果就有明显差别。
模型需要找到相关文件、运行测试,并根据失败继续修改。工具或指令改变后,原有评测成绩不能直接沿用,所以 Harness 配置应与模型版本一起记录。
后训练部分沿着同一个方向投入。DeepSeek 仍采用 SFT、强化学习和 on-policy distillation,主要扩大的是自动合成的 Agent 任务、环境和执行轨迹。训练材料除了题目,还要有能运行的项目,以及检查结果的程序。给模型足够多可以执行、可以判分的长任务,才有条件训练它处理过程中的错误。3
V4.1-Flash 也支持原生图文输入、文字输出。对网页排错来说,截图能和代码、日志放进同一段工作;对文档任务来说,可以直接处理页面和图表。但视觉输入本身不会替模型打开浏览器,具体操作仍由 Harness 提供的工具完成。
其他测试并没有同等幅度的提升。GPQA Diamond 上,V4.1-Flash 为 90.9,低于 V4-Pro 的 92.4;基础模型 LongBench-V2 从前代 Flash 的 44.7 升至 45.2。不能将 Agent 评测变化扩展成所有能力同步提升。
CED 减少长输入计算,缓存另有存储取舍
CED 将 40 层主干分为 20 层因果编码器和 20 层解码器。理解其成本变化,需要先看解码器使用的全局历史表示。
模型生成答案时,需要读取注意力机制保存的历史状态,也就是 KV 缓存。CED 让解码器的全局 KV 直接由编码器末层的隐藏状态投影生成。这样,大部分输入经过前 20 层后,就能准备好后面需要的全局历史,不必把全部输入再完整计算一遍后 20 层。这个方案受到 YoCo 启发,进一步调整了历史表示的生成方式。3
局部状态仍要单独处理。各层保留滑动窗口注意力(SWA),解码器需要重放末尾的一小段输入,准备自己的局部 KV。按报告的 128-token 窗口,简化后的输入计算量从约 40N 变为 20N + 20×128;N 足够大时,才接近减半。
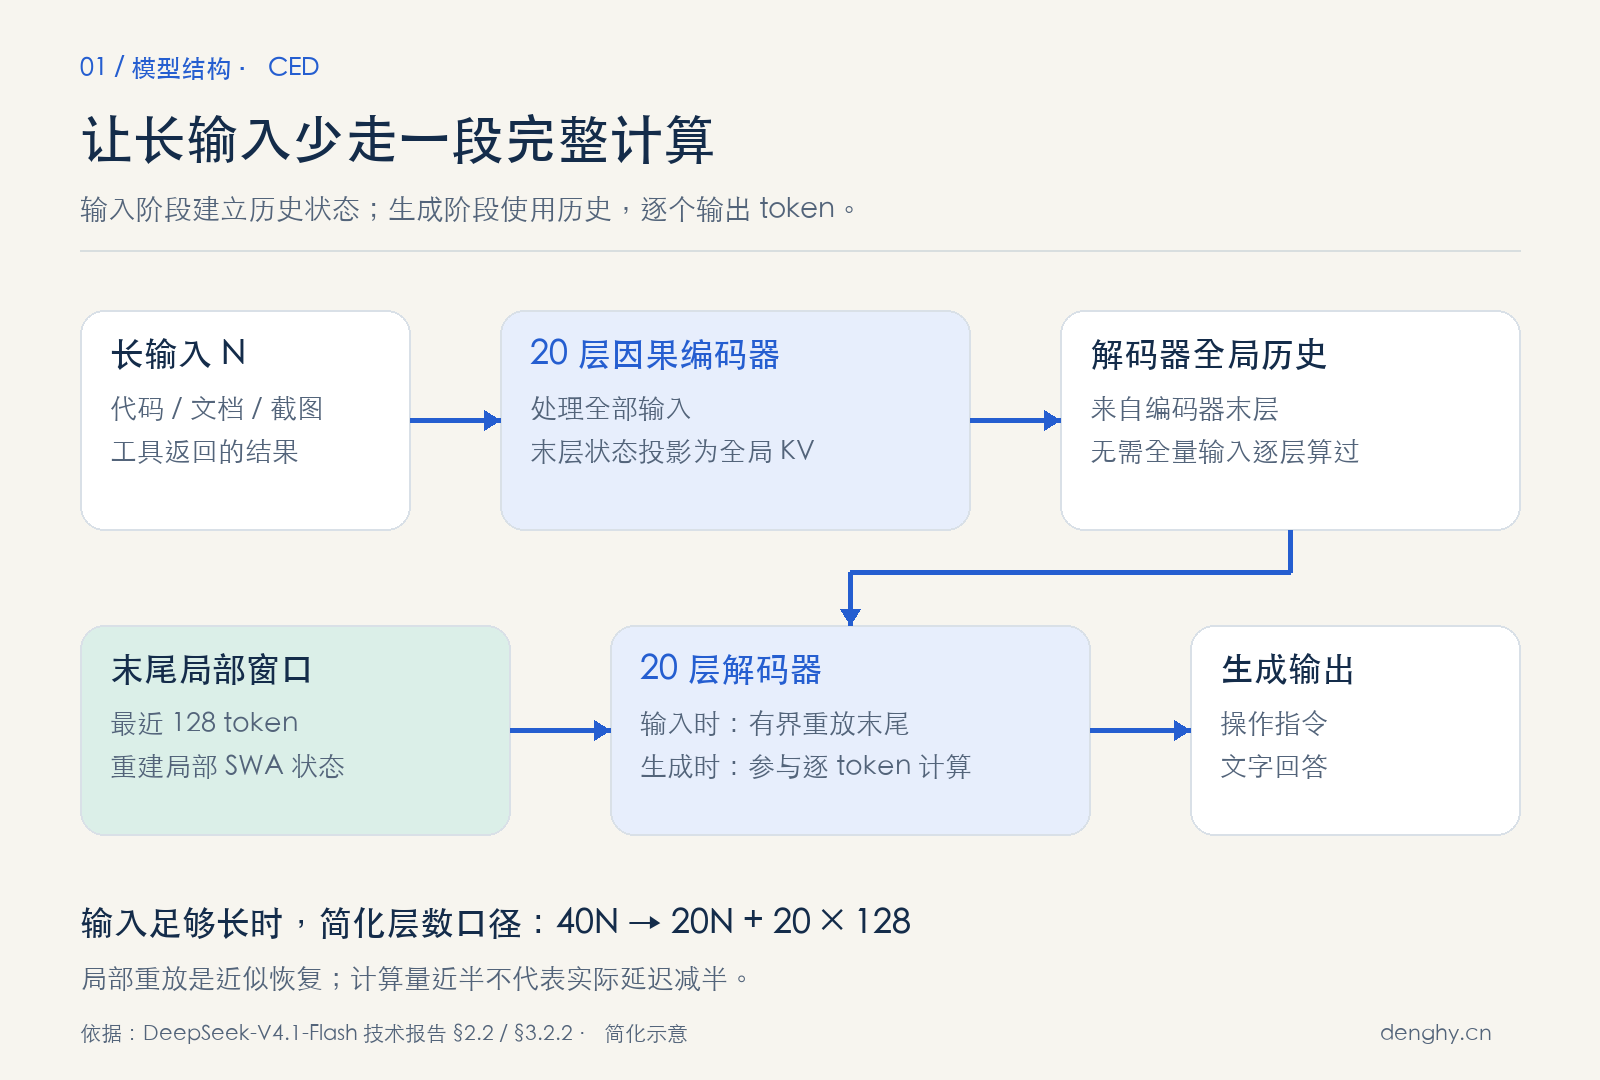
根据报告第 2.2、3.2.2 节绘制。省略投影和跨层共享细节,计算量不等于实际延迟。
激活参数也按阶段区分:前代 V4-Flash 每 token 为 13B,新版为输入阶段 8B、输出阶段 16B。大量输入、较短输出的任务可能更适合这种分工;连续长输出的收益仍需单独测试。
历史状态的存储和查找也做了调整。CSA2 把注意力层分成三种模式:Full 生成共享 KV 和索引键并选择位置;Reindex 用已有缓存重新选位置;Reuse 连选好的 Top-K 位置也复用。各层仍计算自己的查询和局部状态,产生新的输出。这里共享的是历史与检索结果,并没有把上一层的答案直接复制下来。
解码器还会先建立一个候选池,让后续索引层在里面筛选,减少反复搜索整段历史的工作。再叠加 FP4 主 KV 量化,官方给出的全局 KV 占用是每 token 890 字节,约为前代 Flash 的四分之一。1
百万 token 对应约 0.89 GB 全局 KV,看起来很小,但不包含权重、局部缓存和临时张量。模型本身有 552B 主干参数,另有 196B Engram 参数;不能按一个 8B 小模型来准备部署硬件。Engram 用 token 组合查取训练得到的内部记忆表示,也不能当成会自动记住企业新文档的 RAG。
有界重放是另一笔取舍:部分局部 SWA 状态不长期保存到 SSD,需要时用最近一个窗口重建。官方称,持久化 KV 占用因此约为前代的八分之一。恢复的是近似状态,不是数学上等价的无损恢复。 报告明确承认这项差异,也在后训练中模拟重放,让模型适应它。3
「全局 KV 四分之一」与「持久化 KV 八分之一」是不同统计对象,不能相乘。实际速度仍受缓存命中、并发、服务端实现和任务输入输出影响,不能直接按存储比例换算。
按历史报价算费用,别漏掉路由变化与重试
API 费用按价格页计算,不按架构节省比例推算。以下保留 9 月 11 日的 V4.1-Flash 报价,模型 ID 为 deepseek-flash,单位均为美元/每百万 token。4
峰时,Flash 的未缓存输入为 0.30 美元,缓存命中输入为 0.006 美元,输出为 1.20 美元。非峰时价格减半。官方峰时换算为北京时间,是周一至周五的 09:00—12:00、14:00—18:00。
拿 10 万个未缓存输入 token、1 万个计费输出 token 举例:Flash 峰时费用是 0.1×0.30 + 0.01×1.20 = 0.042 美元。按当前 V4-Pro 报价计算,同样的 token 数为 0.1716 美元。这是给定输入输出数量的报价算例,比较对象是 V4-Pro,不是前代 Flash,也没有包含重试或其他工具费用。
单次报价不等于任务总费用。额外推理、工具往返和失败重试可能增加 token;比较时应记录完成同一项合格工作的全部调用,以及人工修补时间。
这里还有一条容易漏看的更新:官方已将 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 的请求转给 V4.1-Flash,旧名称仍能调用,但不再代表旧模型。仅保留旧模型名,已经不能做前后版本对照。 若需要比较,应使用留存的旧运行记录,或能确认实际版本的独立端点。
官方还计划从 2026 年 9 月 14 日北京时间 12:00 起,将 deepseek-v4-pro 请求也转到 V4.1-Flash,并按 Flash 计费。截至本文核对时,这一切换尚未发生。文章里的 Pro 报价比较有明确时间范围,后续应以价格页和实际路由为准。4
Harness 0.1.5 改进材料、会话与文件交付
0.1.5 的主要功能集中在 rc.1,汇总了自 v0.1.2-rc.1 以来的变化。rc.2 于北京时间 9 月 10 日 23:09 发布,主要调整反馈提交和文件卡片排版;这些功能不能全部归到 rc.2。52
新模型适配已经加进来了:显示名称是 DeepSeek-V41-Flash,ID 是 deepseek-flash,支持文本、图片和历史内系统提示更新。新会话默认使用它,显式配置仍然优先。这里说的是 DSH 选择哪个 ID,服务端是否把旧 ID 转到新模型,是上一节说的另一层行为。6
系统提示更新看似不起眼,却和长任务成本直接相关。会话进行中,工具或配置可能变化;如果每次都改写开头的系统消息,原有缓存前缀可能受影响。对声明支持 in-history 的模型,DSH 把更新后的完整系统提示追加到历史中,保留已有前缀。模型协议和框架配合好了,才有机会省下这部分重复输入。实际缓存命中仍取决于服务端。
Web 支持文件与图片上传、进度和取消,并在会话切换后保留状态。通用文件保存为路径,由模型按需调用工具读取。上传成功不能证明解析准确,扫描 PDF、表格公式等仍需抽查。
模型可显式交付文件,右侧 Sidebar 预览 Markdown、代码、HTML、PDF 和图片,也可打开子代理或其他会话产物。这个入口方便检查结果,但预览可打开仍不等于内容通过验收。
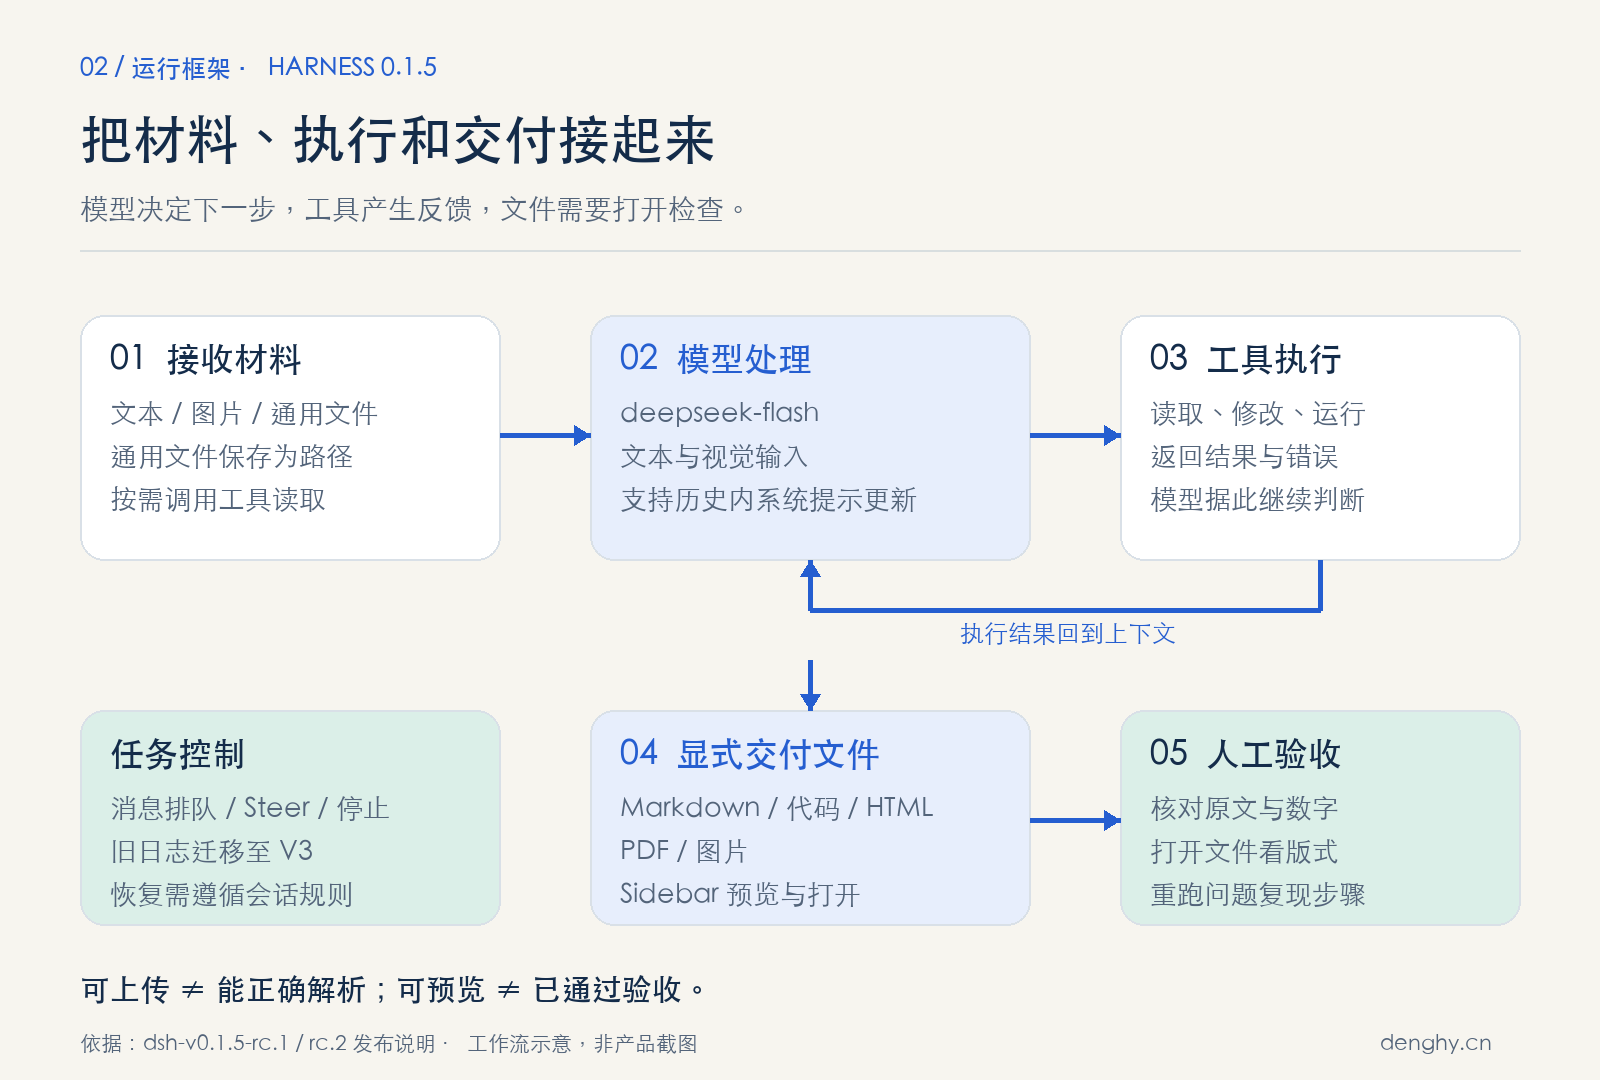
根据 0.1.5 发布说明绘制的工作流示意,并非产品界面截图。文件可预览不等于内容已通过验收。
控制过程也补了细节。子代理支持排队消息、编辑、Steer 和停止;用户暂停目标后,当前模型轮次会中断,恢复必须由用户触发。流式工具调用的后续分片,不再用空值覆盖调用 ID 或名称,避免工具失败后留下无法重新打开的会话。长任务是否好用,常常就取决于这些中途环节。5
rc.2 没有宣布新的模型能力。它让点赞、点踩经过弹窗确认,提交失败时保留已填内容,并调整交付文件卡片、代码图标和对话间距。这是一轮使用体验更新,应该按这个分量评价。
用一个可复现任务检查实际收益
可以选一个带截图的 Laravel 页面问题,在独立测试项目里给出相关代码、脱敏日志和稳定的复现步骤。任务范围不用大,但应要求模型走完:复现、定位、修改、运行相关测试,再回到页面确认。不能运行哪一步,就明确记下来。
最后交付代码差异、修改理由、检查记录和截图。验收时重跑最初的操作,并检查相关正常路径;再中断、恢复一次会话,观察它是否能接着检查,而不是把已完成的工作重做一遍。这个任务能同时用到视觉输入、工具反馈、长会话和文件交付,比较容易看出这轮升级的实际变化。
做内容或教育产品,也可以用一组指定资料试另一条路径:上传教材片段和既有模板,要求输出带出处的 Markdown 草稿,原文没有依据的内容单列。打开产物,抽查页码、数字和图片,再决定是否进入后续制作。上传成功和模型说“读完了”,都不足以说明这一步完成。
以上是试用安排,不是已经完成的测试。比较时固定输入材料、项目版本、工具与权限,记录总耗时、token 用量、实际费用、人工接手次数和最终结果。若拿旧记录作对照,也要保留当时的模型版本与环境,避免把服务端自动换模当成旧模型成绩。
试用要检查的是:同一项任务通过验收时,是否减少了人工接手和总费用。运行更久不能单独证明收益,报价与公开评测也不能代替这份项目记录。
安装与迁移补充
官方仓库声明 Node.js 范围为 ^22.19.0 || >=24.0.0。下面的 npm 版本已核实发布,可以固定下来复现这次更新:7
npx @deepseek-ai/dsh@0.1.5-rc.2 web
默认地址是 http://127.0.0.1:3080。在“设置 → 模型”配置 DeepSeek API 密钥,创建新会话并确认选择 deepseek-flash。已有会话保留其记录的模型 ID,客户端选择和服务端实际模型需要分别确认。自定义网关还要检查协议、图片输入与历史内系统提示更新;目录中出现条目,并不证明网关已开放该能力。86
已有 DSH 用户,升级前先保留数据目录副本。0.1.5 会话格式升级到 V3,受支持的旧日志迁移后生成新版并保留原文件,但升级后的会话不支持降级读取。退回旧程序,不会自动把新增历史变回旧格式。至少选一个带工具调用和附件的旧会话,检查迁移、重开与继续执行。9
自己写过集成的开发者,还需要对照 rc.1 的兼容性变更:agentLoop.create() 变为异步,Session persistence 由 SessionHandle 持有;移除 ctx.agent,通过 agent.inbox 操作消息;Web 的旧 conversation Slot 需要迁移。SDK、Headless、ACP 默认使用 read、write、edit;Web minimal 和 Python sdk-minimal 默认只有持久 shell,str_replace_editor 需显式启用。实验性 Agent Teams 也需要手动添加 profile,不会自动开启。5
资料来源
DeepSeek-V4.1-Flash 官方模型卡。含架构、参数、MIT 许可证、不同 Harness 的评测设置与结果。 ↩ ↩ ↩
dsh-v0.1.5-rc.2 发布说明。GitHub 标记为预发布;北京时间 2026-09-10 23:09 发布。 ↩ ↩
DeepSeek-V4.1-Flash 技术报告。重点参见第 2.2、2.3 节的 CED/CSA2、第 3.2.2 节的 SWA 有界重放,以及后训练、评测和限制部分。 ↩ ↩ ↩
DeepSeek 官方模型与价格页,2026-09-11 核对。包含峰谷价格、旧模型别名转发,以及 9 月 14 日 Pro 路由调整计划。价格与路由可能继续变化。 ↩ ↩
dsh-v0.1.5-rc.1 发布说明。本系列主要功能与兼容性变更。 ↩ ↩ ↩
rc.2 运行说明、Node.js 版本范围和npm 固定版本。安装命令经过发布元数据核对,本文未启动 DSH 或执行付费模型请求。 ↩
V2 → V3 会话迁移说明。降级读取限制另见 rc.1 发布说明。 ↩