本文记录 2026 年 8 月 19 日至 21 日的版本变化。DeepSeek Harness 的 rc.8、rc.1 和 rc.2 分别处理图文输入、视觉模型接入,以及图片上传与预处理。模型能读截图后,任务仍需要代码、工具和实际页面共同验证。
排查页面错位时,代码和日志并不包含全部信息。截图、设计稿和图表可以补充视觉证据,减少先把画面逐项翻译成文字的工作。
DeepSeek-V4-Flash-Vision-Exp 提供图片理解;同一时期的 Harness 更新负责把图片送入任务并保存相关状态。
图片进入会话后,还要处理命令和子代理引用、历史载荷、修改后的验证以及人工确认。模型描述一张截图,不能代替这些执行步骤。
三个版本分别处理输入、模型和上传
这三次更新承担不同工作,应分别读取发布说明,不把全部功能归到最后一个版本。
rc.8 增加图文输入和引用支持:
- DeepSeek 模型适配器可以配置原生图片请求;
/goal、/plan等命令可以接收图文输入;@菜单可以引用文件和会话;- MCP 与 ACP 的图片附件能够持久化,PTC Mode 可以转发嵌套图片;
- 过大图片和历史图片累计载荷导致的请求失败得到修复。
同一个版本还扩展了执行侧:Claude Code 与 Codex 子代理可以作为 Profile Bundle 按需安装,支持非交互权限模式和多个命名实例;Windows PTY 增加持久 PowerShell 会话;web_search 支持并发查询;子代理交付结果可以及时唤醒父任务。
rc.1 在 DeepSeek 适配器中加入 DeepSeek-V4-Flash-Vision-Exp。rc.8 先提供图片传递方式,rc.1 再接入负责理解图片的模型。
rc.2 优先使用 Files API 上传图像,并复用已上传文件;预处理流程按模型要求自动缩放和转换格式。这一版改进图片传送,不是新增视觉模型。
rc.1 还修复了 Bubblewrap 受限进程可经 /proc/<pid>/root 绕过限制的问题。允许 Agent 调用工具和修改文件前,应同时检查沙箱与工作区权限。
其余改进更偏向日常使用,包括 ask_user_question 支持多行输入和 Shift+Enter 换行、Markdown 表格自适应、99.x% 缓存命中率精度显示、子代理会话标题切换,以及编辑 @ 引用前方文本时的布局修复。
视觉模型的能力与厂商评测边界
当时的官方定义是实验性多模态视觉理解模型。请求中设置:
model="deepseek-v4-flash-vision-exp"
模型可以描述图片、识别截图文字、分析图表,也可以在 Agent 工作流里读取页面截图、设计参考和视觉执行结果。
DeepSeek 官方称,模型的纯文本能力与 DeepSeek-V4-Flash 正式版持平,在视觉 Agent Benchmark 上优于纯文本版本,多模态 Agent 能力接近 Opus 4.8。这些是厂商披露的测试结果,本文未独立复测。
官方演示包括旅行 PPT、开发者网站重构和带动态效果的前端 Demo。这些案例展示了视觉理解与生成工作的组合;项目采用前,仍需检查代码、实际页面、性能和可访问性。
API 输入方式与限制
按 2026 年 8 月 21 日的文档,视觉模型支持以下接口:
- OpenAI 兼容的 Chat Completions;
- Anthropic 兼容的 Messages;
- OpenAI 兼容的 Responses API。
图片可通过 Base64、外部 HTTP 或 HTTPS URL,以及 Files API 的 file_id 传入。以下保留原文的 Chat Completions 示例,使用前应核对现行模型路由:
from openai import OpenAI

client = OpenAI(
    api_key="<DeepSeek API Key>",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "检查这个页面截图,指出布局问题。"},
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/screenshot.jpg",
                        "detail": "low",
                    },
                },
            ],
        }
    ],
)

print(response.choices[0].message.content)
历史文档支持 JPEG、PNG、GIF 和 WebP。外部 URL 图片上限为 32 MiB,Files API 的 file_id 图片上限为 64 MiB,内联请求体上限为 48 MiB;单次请求最多 600 张图片。这些是接口上限,具体任务仍应限制图片数量与尺寸。
detail 可以选择 low、high、original 或 auto。其中 low 会在推理前把图片缩放到 512×512,更适合不依赖细节的快速检查。每张图片在模型处理前会自动缩放,图片 token 上限为 384;官方文章说明图片按 token 计费,价格与 V4-Flash 相同。
Files API 本身不收费,适合多次复用同一张图片或避免重复上传大文件,但模型读取图片产生的 token 仍会计费。
rc.2 将 Files API 复用放进适配器,减少多轮任务中的重复上传;自动缩放和格式转换则处理输入图片与模型要求之间的差异。文件复用仍需遵守项目的数据和凭据范围。
把截图放进可检查的任务流程
修复前的截图用于说明现象,修复后的截图用于比较结果。两者都应与代码和工具检查对应。
例如修复一个前端页面,可以把流程设计成:
- 输入问题截图、目标参考图和明确验收标准;
- Agent 结合仓库代码、DOM、网络请求和截图形成假设;
- 在受控权限范围内修改代码并运行工具;
- 执行测试、构建、DOM 或 API 检查;
- 重新截图,与目标状态做视觉比较;
- 高风险修改进入人工审批,失败则回到上一轮修正。
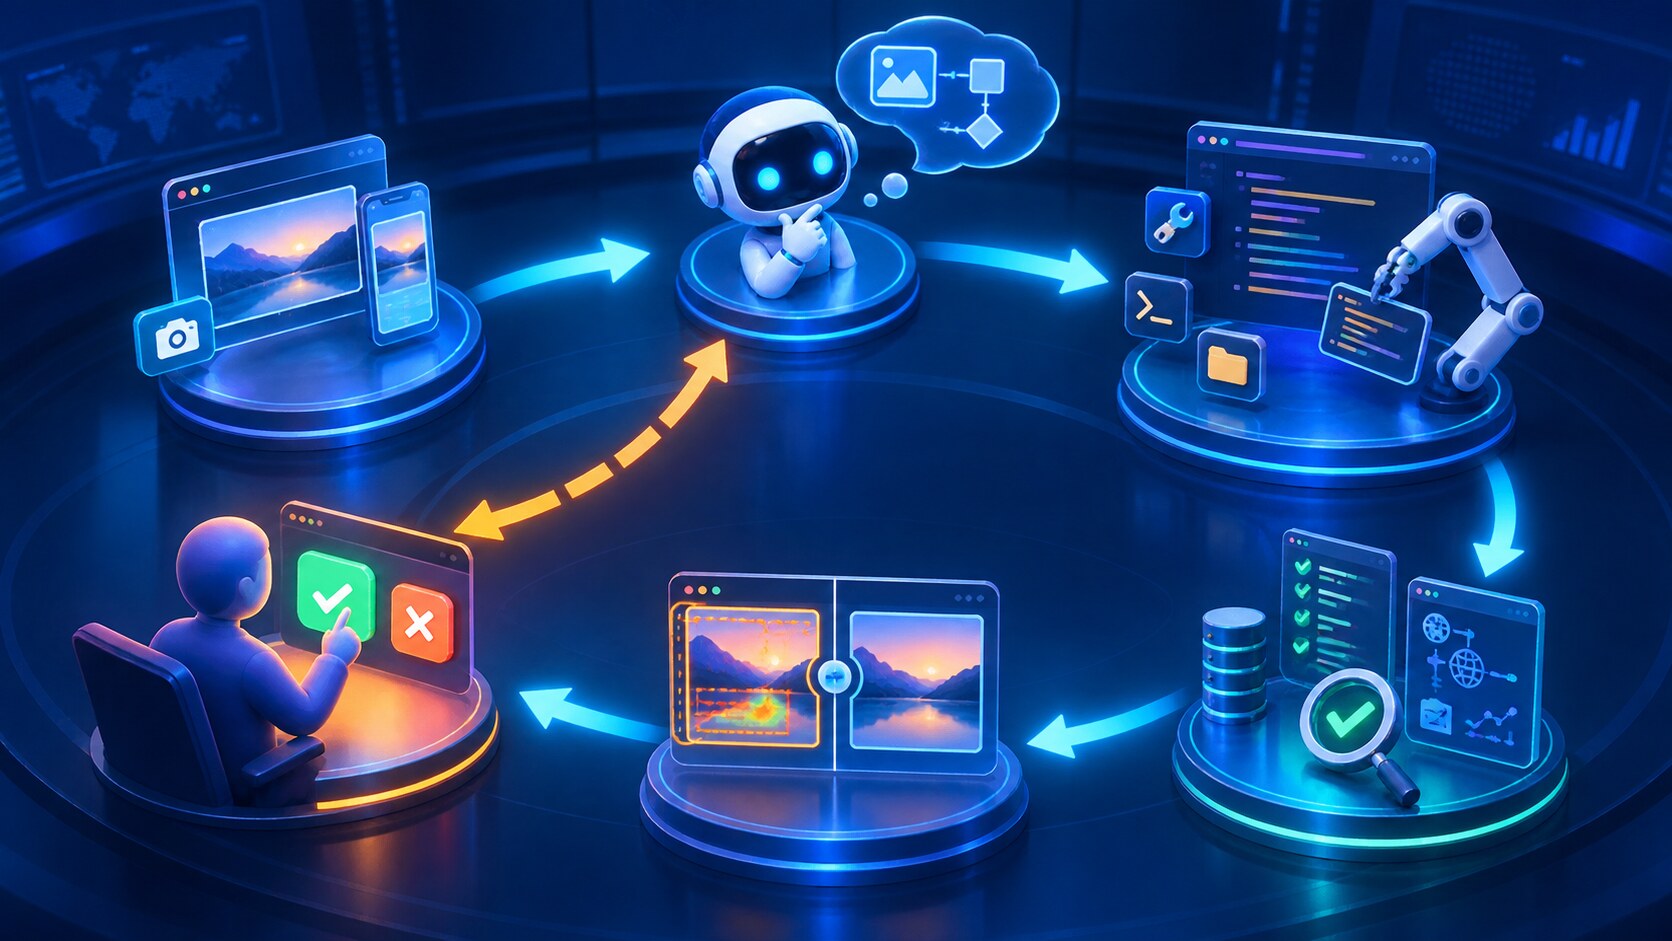
这个流程中,视觉模型提出判断,工具提供可重复检查的结果。截图适合发现画面问题,但不能单独证明 DOM 语义、权限、接口、键盘操作和移动端断点均正确。
复现历史版本前的检查
第一,确认版本性质。本文引用的三个 Release 均标记为 prerelease,原版 README 说明其处于开发者预览阶段,可能有不兼容变化。
第二,固定确切版本,不要让生产工作流自动追随 latest:
npx @deepseek-ai/dsh@0.1.1-rc.2 web
第三,检查 Node.js。v0.1.1-rc.2 仓库根配置要求 Node.js ^22.19.0 || >=24.0.0。
第四,升级前备份会话数据。rc.8 的 Release 明确说明 SQLite 后端的数据结构不兼容;即使新实现改善了读写、分叉性能和存储体积,也不能跳过备份与回滚验证。
第五,不要跳过安全版本。rc.1 包含 Bubblewrap 沙箱绕过修复;如果工作流允许 Agent 执行命令或写入文件,应把沙箱、工作区范围、凭据隔离和人工审批一起复测。
第六,为图片建立预算和验证规则。限制图片数量与尺寸,按任务选择 detail,确认 Files API 文件复用符合项目的数据与凭据边界,不要把视觉判断直接当作完成证据,并在长会话中监控历史图片载荷。
采用前仍需验证的结果
这组版本让图片可以进入任务、交给视觉模型,并经过上传复用和预处理。采用时还要检查会话状态、权限、工具结果和实际页面。
本文记录历史更新,未完成独立模型评测,也不确认今天旧模型 ID 的服务端路由。文中配图为方法示意,不能作为软件运行或测试通过的证据。
资料来源:
- DeepSeek Harness v0.1.0-rc.8 Release
- DeepSeek Harness v0.1.1-rc.1 Release
- DeepSeek Harness v0.1.1-rc.2 Release
- DeepSeek API 图像理解指南
- DeepSeek Harness 更新:官方多模态支持
- V4-Flash-Vision-Exp 上线,开启多模态 API 服务
资料核对时间:2026-08-21。模型与 Harness 均在快速迭代,实际使用时请以最新官方文档、Release 和价格页面为准。