封面为 AI 生成的概念插画,用于表达能力、成本与权限的取舍,不是评测结果或软件截图。
Fable 5.1 的长任务表现、Astra 的网络安全能力,以及国产模型的开放权重,让「AGI 是否临近」再次成为讨论焦点。判断这些变化,需要分别看能力、使用成本和获得条件。
本文保留截至 2026 年 9 月 2 日的资料口径:当时 OpenAI 正在准备发布 Astra,Kimi K3、GLM-5.3 和 Qwen3.8-Flash-Next 已有各自的发布安排。下面的「已上线」「待发布」均指这个历史时点,不作为今天的可用性清单。
先区分上线、实验 API 和开放权重
- Claude Fable 5.1:已经上线,闭源。重点是长任务、科研、编程与更低的 Agent 成本。
- OpenAI Astra:官方称正在准备发布,尚无日期。它是首个达到 Critical 网络安全能力门槛的 OpenAI 模型。
- Kimi K3:已经上线并开放权重。特点是 2.8T MoE、原生多模态、1M 上下文和长程 Agent。
- GLM-5.3:已经开放权重,主打 Agent 编程和网络安全防御。
- Qwen3.8-Flash-Next:已经开放权重,生产 API 将上线,也是 Qwen4 架构的早期预览。
- DeepSeek-V4-Flash-Vision-Exp:实验 API 已上线,未承诺开放权重,正式版仍待观察。
这些状态对应不同使用条件。网页可用不代表权重可下载;实验 API 上线也不代表正式版、生产接口和权重会同时提供。
开放权重之外,还需要分别检查训练数据、训练代码和商业许可。下文采用「开放权重」口径,不将它自动等同于完整开源。
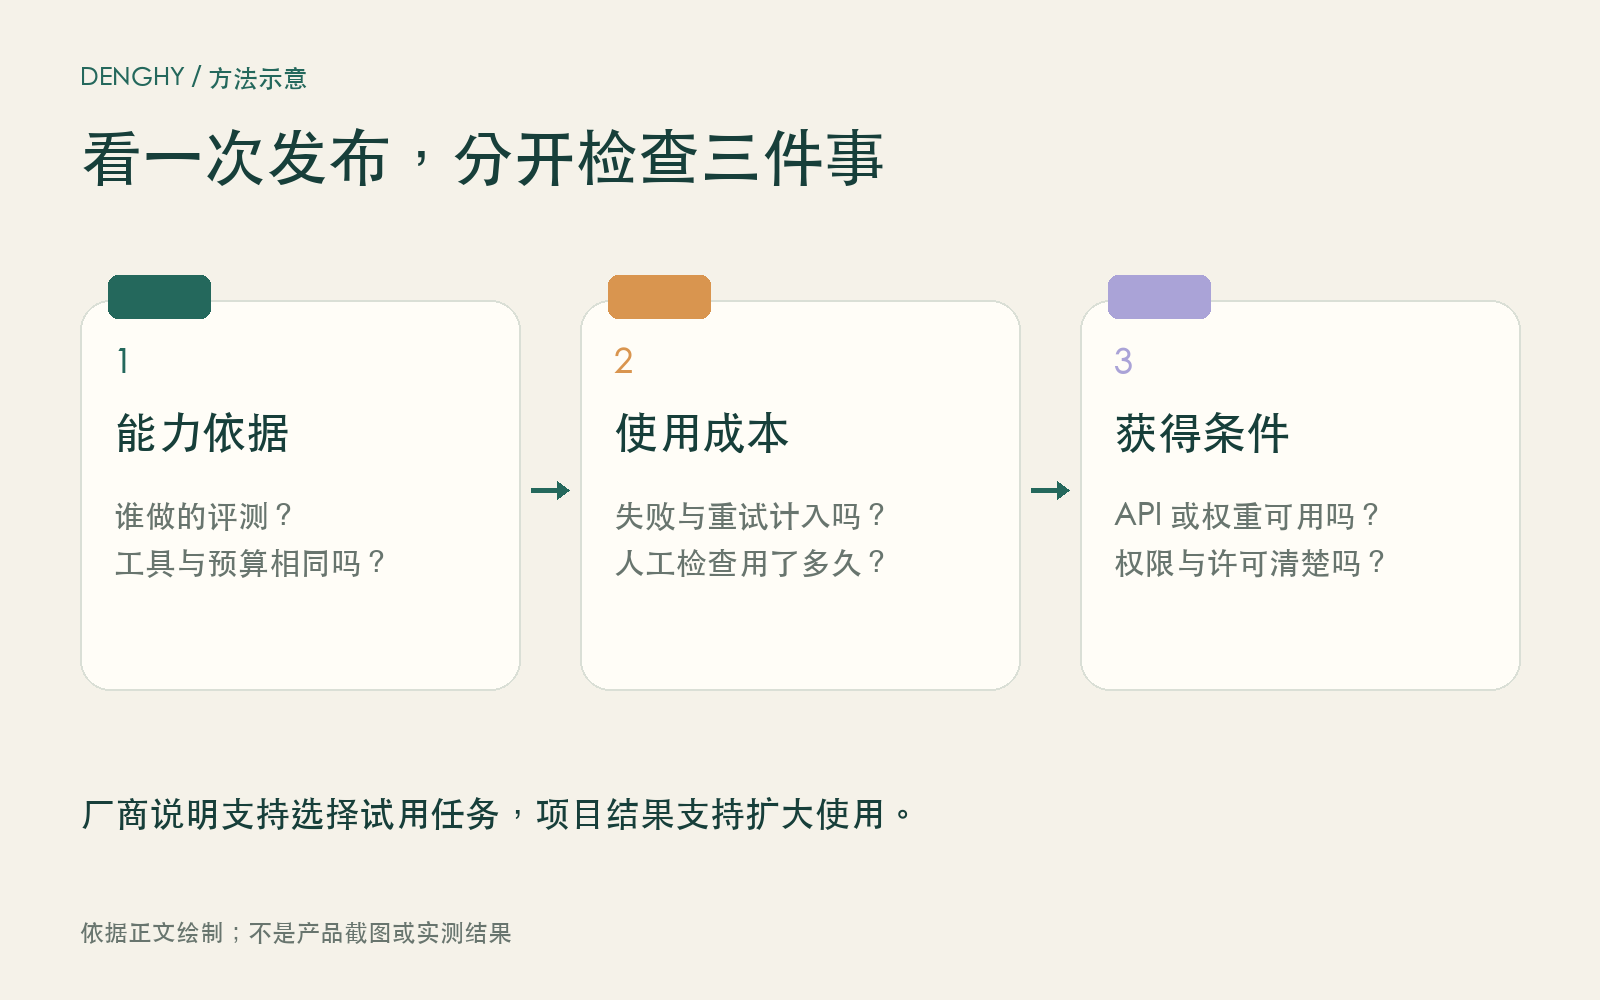
原创方法示意,依据正文绘制;不是软件截图或实测结果。
Fable 5.1:长任务成绩需要和成本一起看
Anthropic 这次同时发布了 Fable 5.1 和 Mythos 5.1。Fable 面向编程和知识工作,已经全面可用;Mythos 更偏网络安全防御和生命科学,目前只通过可信访问计划提供。本文讨论的是前者。
Anthropic 重点强调 complex, long-running tasks,即复杂、持续时间长、需要反复使用工具的任务。科研也是官方举出的方向,但研究能力的发布说明不能代替项目中的独立验证。
官方公布的成绩包括:Terminal-Bench-Science 0.1 从 Fable 5 的 24.7% 提升至 52.6%,Terminal-Bench 4.0 从 42.0% 提升至 55.8%,计算机操作从 72.9% 提升至 77.9%。它们分别涉及科学终端、命令行和电脑操作任务。
比较成绩时要同时读取运行预算、工具配置和提示词。52.6% 表明在该测试口径下比前代有明显进步,但得分距离满分仍有差距。厂商公布的领先项目不能直接推导成所有工作都领先。
成本决定长任务是否值得持续运行。Anthropic 称缓存读取价格比 Fable 5 低 75%,典型工作负载实际成本约下降 25%,高度 Agent 化的任务最多下降 45%;较低 effort 也可降低调用成本。这些是厂商口径,自己的项目仍要计入失败、重试和人工检查。
官方还称,网络安全防护对正常请求的误拦截约减少 60%,基础生物和医疗问题触发 fallback 的比例约减少 85%。这些数字说明厂商在调整防护效果,不能当作所有实际请求的通过保证。
这组发布材料支持优先评估长任务:在相同输入和工具下,检查是否减少人工接手,以及通过验收的总成本是否下降。它还不能直接证明生产任务已经稳定。
Astra:强行动能力带来了更高的开放门槛
截至 9 月 2 日,OpenAI 的原帖和技术说明使用「正在准备发布 Astra」,没有给出发布日期,也没有将它命名为 GPT-6 或 ChatGPT 6。讨论产品代际时,应保留这个命名边界。
OpenAI 当时先披露的是网络安全能力:Astra 是其首个被认定达到 Critical 门槛的模型。按 Preparedness Framework 的说明,在合适工具和访问权限下,这涉及寻找加固系统中的未知漏洞、开发利用方式和组织端到端攻击。这里引用的是厂商的能力分类,不能据此认定普通账号具有相同权限。
OpenAI 公布的内部测试结果包括:
- Astra 在 ExploitBench 上拿到 100%,随后在包含 20 个近期高危 V8 漏洞的内部测试中,用更少的输出 token 达到显著高于 GPT-5.6 Sol 的任意代码执行率。
- 测试过程中,它在一条利用链里发现并使用了两个零日漏洞,OpenAI 正在向维护者披露。
- 在专家测试中,它完成了浏览器沙箱逃逸并在宿主机执行命令,也把多个操作系统漏洞组合成了从普通用户到 root 的本地提权链。
这也是 Astra 没有直接全量开放的原因。OpenAI 曾暂停部分训练,并推迟更大的强化学习训练,先补训练环境隔离、监控和对齐要求。发布初期,高级网络安全能力只给少量测试者,随后再通过 Daybreak Blue 扩大防御用途;普通用户拿到的不会是毫无限制的同一套能力。
OpenAI 还公布了一些对齐结果。面对不允许的网络攻击请求,Astra 的拒绝率是 91.5%,GPT-5.6 Sol 是 59%。在模拟模型会不会绕过周边安全设施的“蜜罐”测试中,未加生产防护的 GPT-5.6 Sol 有 56% 的尝试越界,Astra 没有出现同类行为。上线后还会叠加推理过程监控,发现未授权动作时自动停下;在 ChatGPT 或 Codex 里,用户可能会被要求复核后再继续。
这些结果来自 OpenAI 自己的测试,不能当作外部审计。评估其开放安排时,还要看工具权限、隔离环境和监控怎样约束行动,而不能只看回答质量。
三条开放权重路线,各自强调不同工程条件
按本文历史资料,Kimi K3、GLM-5.3 和 Qwen3.8-Flash-Next 已开放权重。它们的规模、任务方向和部署成本不同,需要分别评估。
Kimi K3 是最激进的规模路线:2.8T MoE 参数、原生多模态、1M 上下文,目标直接写成 long-horizon agentic coding 和 self-evolving workflows。Kimi Delta Attention 用来降低百万上下文的解码成本,官方给出的最高加速是 6.3 倍;Attention Residuals 则称以不到 2% 的额外成本换来约 25% 的训练效率提升。K3 已在产品和 API 上线,权重也已按计划开放。
GLM-5.3 的方向更集中:Agent 编程和网络安全防御。它在 8 月 28 日开放权重,可以下载、私有运行和定制。它和 Astra 的有趣对照是,同样把网络安全当作前沿能力,Astra 先强调访问控制,GLM-5.3 则直接提供权重。能力上限和部署自由之间的取舍,会越来越明显。
Qwen3.8-Flash-Next 更像一张技术预告。它有 125B 模型参数和 51B N-gram embedding,每个 token 只激活 6B;使用 GDN 与 QSA 混合注意力、Gated Residual、N-gram Embedding 和 Muon 优化器,原生上下文 262K,可用 YaRN 扩到 1M。官方称训练成本只有 Qwen3.7-Plus 的九分之一,同时在编程和办公任务上更强。权重已经开放,生产版 API 也宣布将上线。
从这些官方说明看,Kimi 强调大规模稀疏模型和长程任务,GLM 集中于 Agent 编程与安全,Qwen 强调架构效率和部署成本。选择时应对应实际任务与硬件条件,不能只按参数规模排队。
后续型号只记录有依据的信号
第一是 Qwen4。这是目前证据最硬的下一代国产开源模型信号。Qwen 官方明确说,Qwen3.8-Flash-Next 是正在探索的 Qwen4 架构先行版。由此可以合理期待 Qwen4 延续混合注意力、稀疏激活、长上下文和原生多模态,但参数规模、完整型号、开放时间和许可证都还没有官宣。能说“会来”,不能替官方写日期。
第二是 DeepSeek-V4-Flash-Vision 的后续版本。8 月 21 日上线的是 Exp 实验 API:文本能力对齐 V4-Flash,在多模态 Agent 评测上接近 Opus 4.8,并支持图像、Files API 和多种接口。按照实验版到正式版的常见节奏,后续稳定版本值得期待;但 DeepSeek 没有承诺正式名称、发布时间或开放权重,所以它只能列入观察名单,不能写成“马上开源”。
至于 Kimi 和 GLM,目前官方没有公布 K3 下一型号或 GLM-5.3 后继模型的发布日期。它们刚完成一轮大版本和权重发布,更现实的近期变化可能是推理版本、工具链、量化版本和部署生态补齐,而不是立刻再跳一个主版本。没有官方信号时,少写一个型号,比编一个倒计时更有价值。
这些变化还不能替代可靠交付
本文的判断是:能力、成本和获得方式都在变化,但仍需要核对任务失败、恢复过程和权限控制。
Fable 5.1 的厂商数据支持重新评估长任务成本;Astra 的内部测试说明行动能力需要更严格的控制;开放权重模型提供下载和定制的选择。它们分别改变了工程条件,不能合并成一个已实现 AGI 的结论。
任务持续运行不能单独证明过程可靠,发现漏洞不能替代对现实后果的判断,私有部署也不能自动提供权限控制。
项目验收还要检查:模型能否明确不确定信息,错误后能否恢复,陌生环境中是否守住目标与权限,以及操作原因和结果是否可以核对。
对开发者而言,可以先把一项结果明确的工作交给 Agent,记录通过验收的结果、总成本和人工接手次数。这些记录能支持下一次使用决定;发布会和榜单不能代替它们。