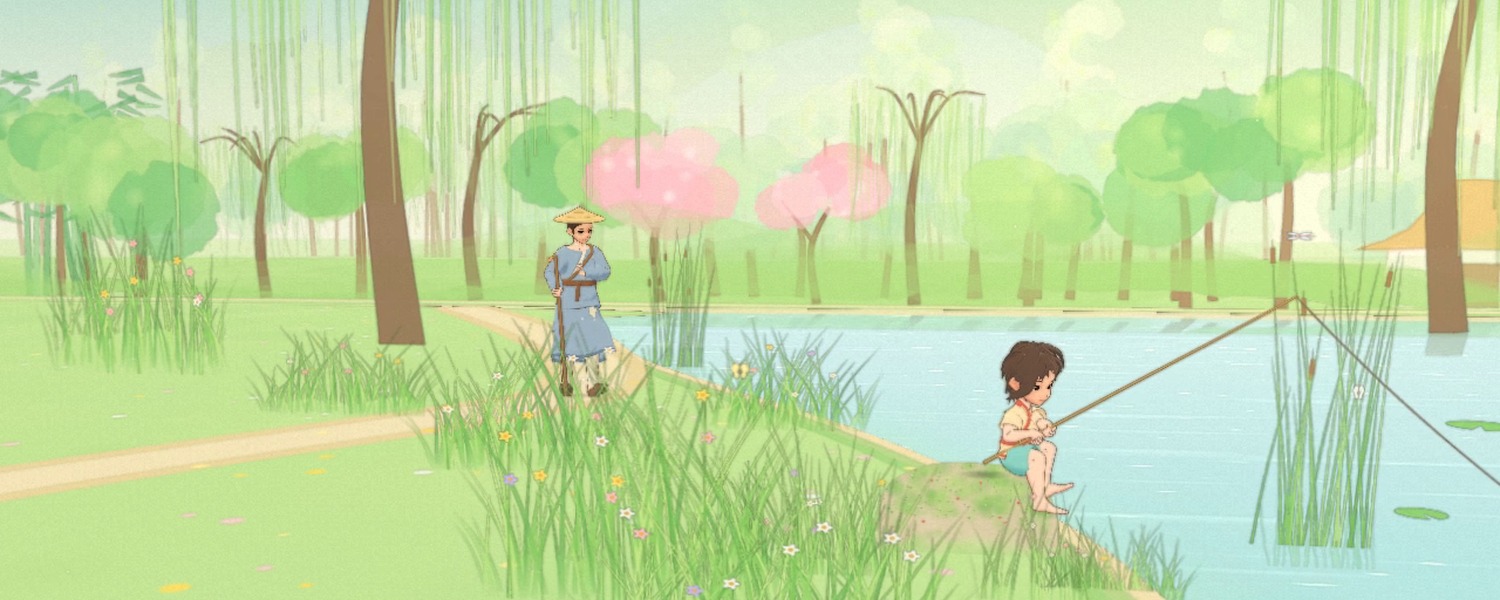
已发布 · 2026-11-12 22:33(上海时间) · 原文链接
一首 28 个字的古诗,我和 AI 在一天里做了 9 版视频,最后一版也只能算勉强能看。
三天后换了个做法,让 AI 写代码,一帧一帧把画面"算"出来,这次总算过了我这关。
两段加起来,占了我过去 7 天 Bot 用量的七成左右。下面把过程、坑和账都摊开。
我要的其实不复杂
诗是胡令能的《小儿垂钓》:"蓬头稚子学垂纶,侧坐莓苔草映身。路人借问遥招手,怕得鱼惊不应人。"
我想给孩子做一条二十来秒的讲解短片:国风水彩,闲适、天真;男声朗诵,有停连有重音;四句都有连续的动画;孩子招手要对上"遥招手"这三个字,鱼轻轻一惊又恢复平静,别演成吓跑;结尾回到孩子身上定格。
每一条,后来都成了坑。
第一次:视频模型,一天 9 版
我的助手 Fobo 先出分镜图,我确认了再做动画。
分镜阶段就不顺:鱼竿要么不完整,要么手没真握住;鱼篓这张是收口的,下一张又变成敞口筐;第四张的鱼像贴在水面上,不像在水下。
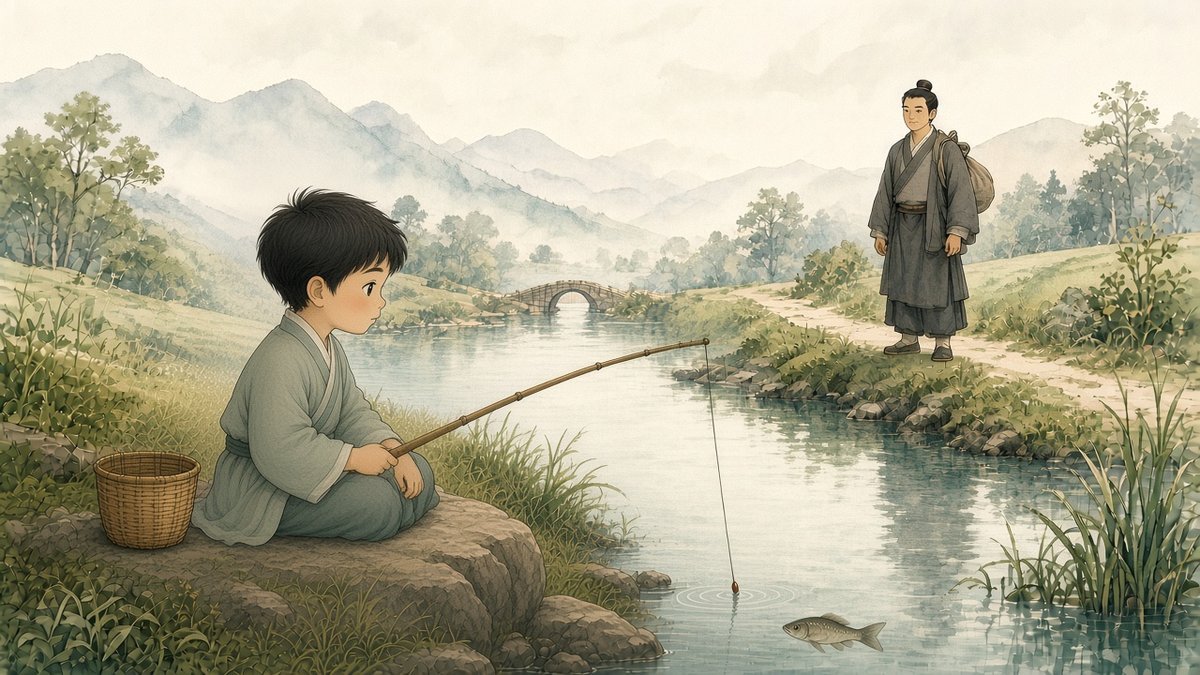
第四张分镜:鱼像浮在水面上,鱼篓也变成了敞口筐
动画这边,前三版用的是两段生成素材。源片只有 736×400,放大到 720p;时长不够,就用光流慢放、补帧去凑。第二段大全景里孩子的手是畸形的,v2 干脆裁成脸部特写把手藏起来,结果源画面只剩 120×140,糊得厉害,"遥招手"这个动作也跟着没了。配音是标准女声 TTS,参考视频其实是开头诵读、正文用旋律唱,一遍四句约 12 秒,节奏完全没对上。
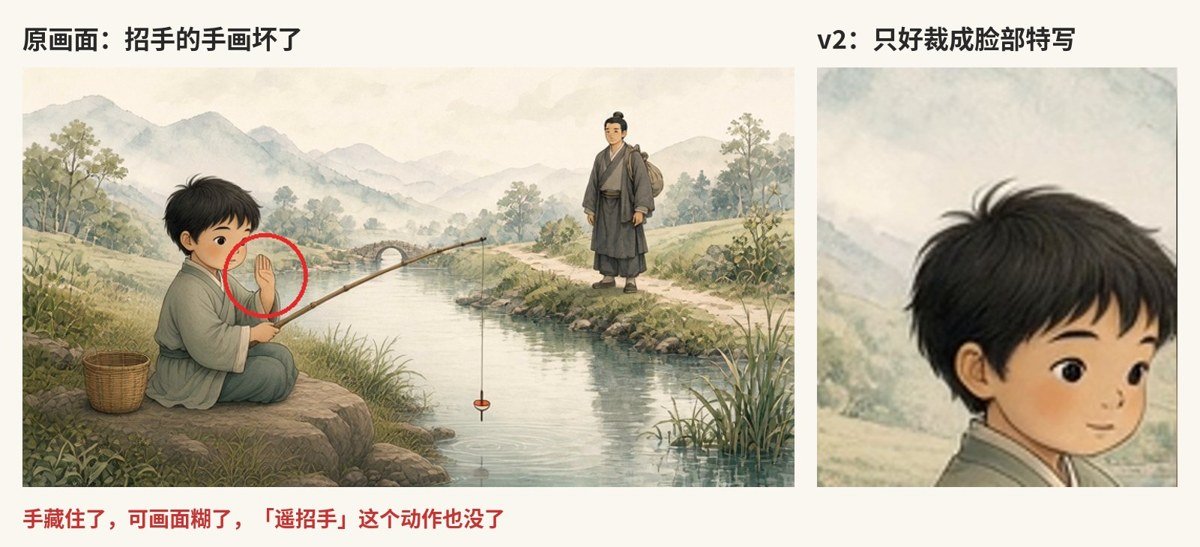
左:原画面招手的手画坏了;右:v2 只好裁成脸部特写,「遥招手」也没了
v4 换成男声 TTS,画面拉到 25.8 秒,靠的还是旧素材慢放。我否了:慢放、插帧、循环,一律不许。
v5 全部重新生成原速镜头,配音改用视频模型生成时自带的男声旁白。新问题:每句是单独生成的,四句是四个嗓子;第四句模型还自作主张在画面上烧了一行乱字幕,整段画面只能扔掉。
v6 是转折点:先锁音轨。单独生成了 6 条整段朗诵,挑出 take-e,一条到底,不切、不变速。之后所有画面都按这条音轨每句的实际时长来做。
v7 到 v9,按音轨重新生成镜头,下一镜首帧接上一镜末帧。还是按下葫芦浮起瓢:草跑到孩子身后,衣服在一个镜头里从灰绿变成浅绿,水下的鱼和孩子叠出"幽灵"。v9 修掉了这些,又留下手举着不放、开头闭眼半秒这类小毛病。
最后数了一下,文件夹里留下的视频生成片段有 28 段,还不算角色图和分镜图。
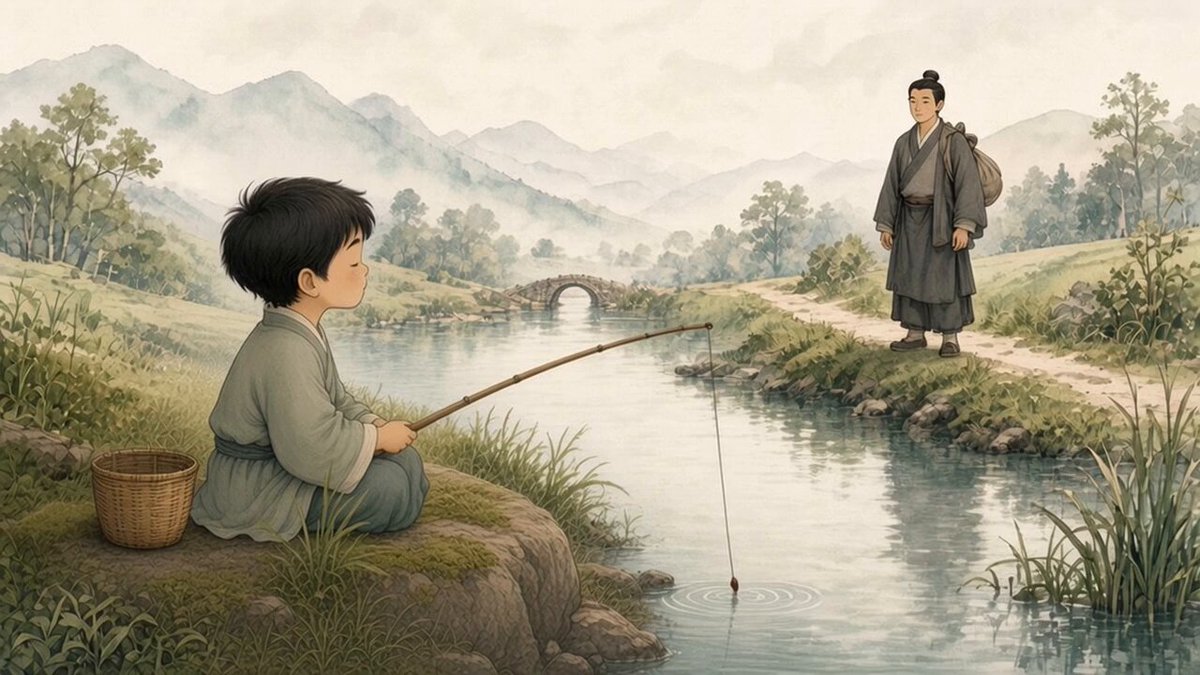
小儿垂钓-视频模型第9版
第二次:让 AI 用代码"写"视频
三天后,我把这活交给另一个专门做科普视频的 Bot,Fobo 只负责审稿。
技术栈是 HTML + Canvas 2D 程序化画水彩,three.js 做纵深和水面,角色后来换成 3D 骨骼模型,无头 Chrome 逐帧渲染,ffmpeg 合成。
核心就一句:每一帧画面都是时间 t 的函数,同一个 t 永远得到同一帧。
好处很直接:
音轨复用第一次留下的 take-e,脚本做静音检测,自动算出每句起止,
镜头长度就等于音轨长度,慢放补帧根本没机会出现。

"招手要在'遥招手'字音内完成,'怕得鱼惊'之前手回到竿上",
在代码里就是几个时间数字,可以精确到 0.1 秒。

take-e 里没有诗题,就用开源声音克隆,
拿 take-e 前两句当参考补录,音色能接上。
坑一:人物是"凭空画"出来的木偶。 一开始,做视频的 Bot 完全用代码画人,四肢是一段段贴片拼起来的,没参考任何正确的人体结构。Fobo 的审稿意见很具体:两手分开一拳半,竿尾露出后手;招手从身侧抬起,别从头顶绕;远侧那条腿要露出来……它就一条条改。可这处改好,脖子、关节、臀腿又冒出新毛病,怎么看都还是木偶。我指出这是在打补丁,它也认了:问题出在根上,没有一个结构正确的底子。
最初纯代码画的人物:怎么改都还是木偶
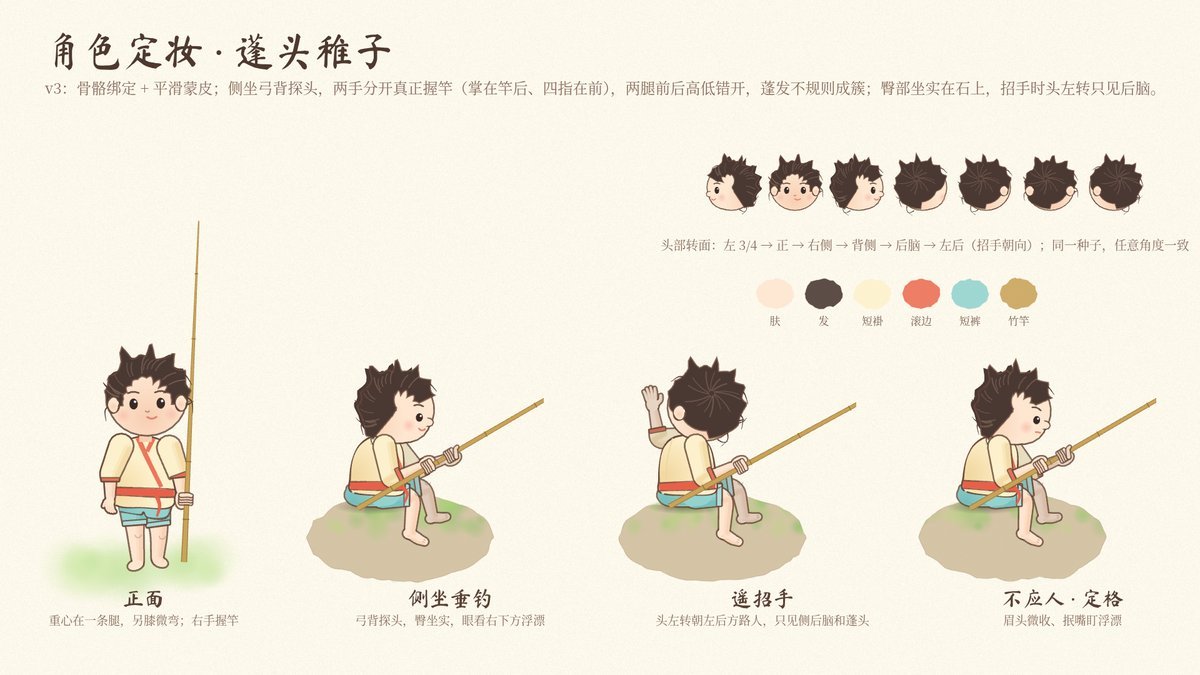
后来换了思路:先有正确的人体,再用代码去驱动。它给了两条路,一是用自带标准骨骼的现成 3D Q 版儿童模型,放进 three.js 加描边和水彩着色;二是先用 AI 生成一张定妆三视图,拆成图层,做皮影式的骨骼动画。最后用的是第一条:拿 VRoid 官方 CC0 样例改成 Q 版孩子,脖子、肩肘、髋膝都是真骨骼,转头、招手、坐下都按真实关节来动。
坑二:脸越改越走样。 换了模型,脸又出了问题。它在原模型的脸上一处处推拉网格、改贴图,没拿标准的孩童脸做参考,越改越怪;缩到定妆图的尺寸,五官糊掉一大半。我指出来以后,它换了做法:先查几份 Q 版孩童脸的比例参考,把眉、眼、鼻、嘴的位置定成数字;五官直接用 VRoid 原套的成品贴图,只改颜色;脸型只做整体圆润,不再局部推拉;先出一张大头特写给我确认,再套回全身,同时检查缩到头高约 80 像素时五官还看不看得清。
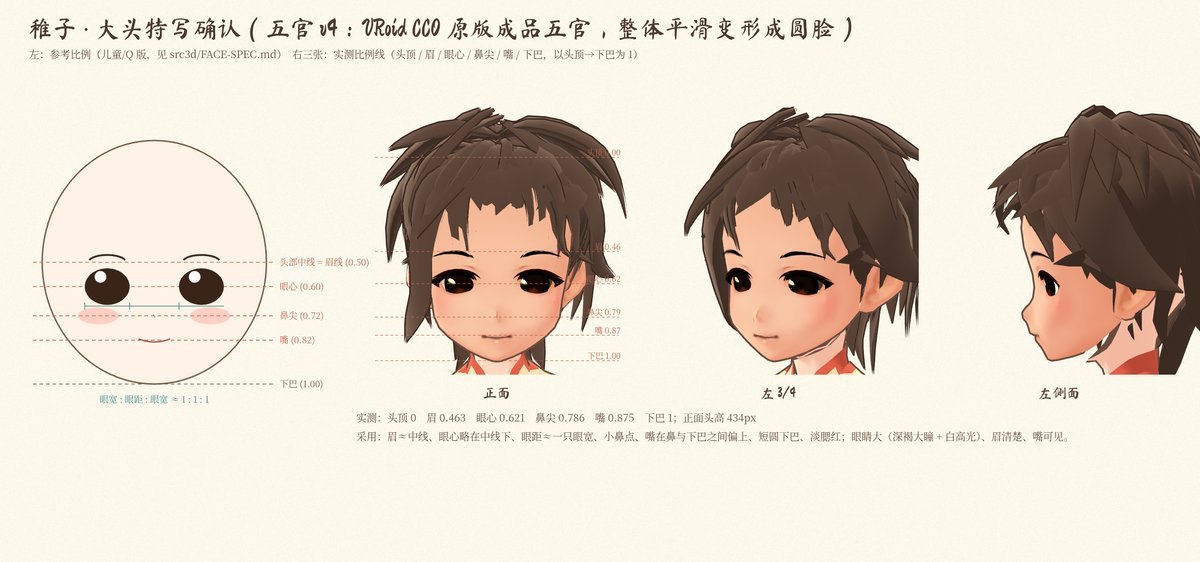
修正后的大头特写:先定比例参考,再用成品五官
人和脸都定下来,再出一张 10 帧的招手序列,逐帧核对。
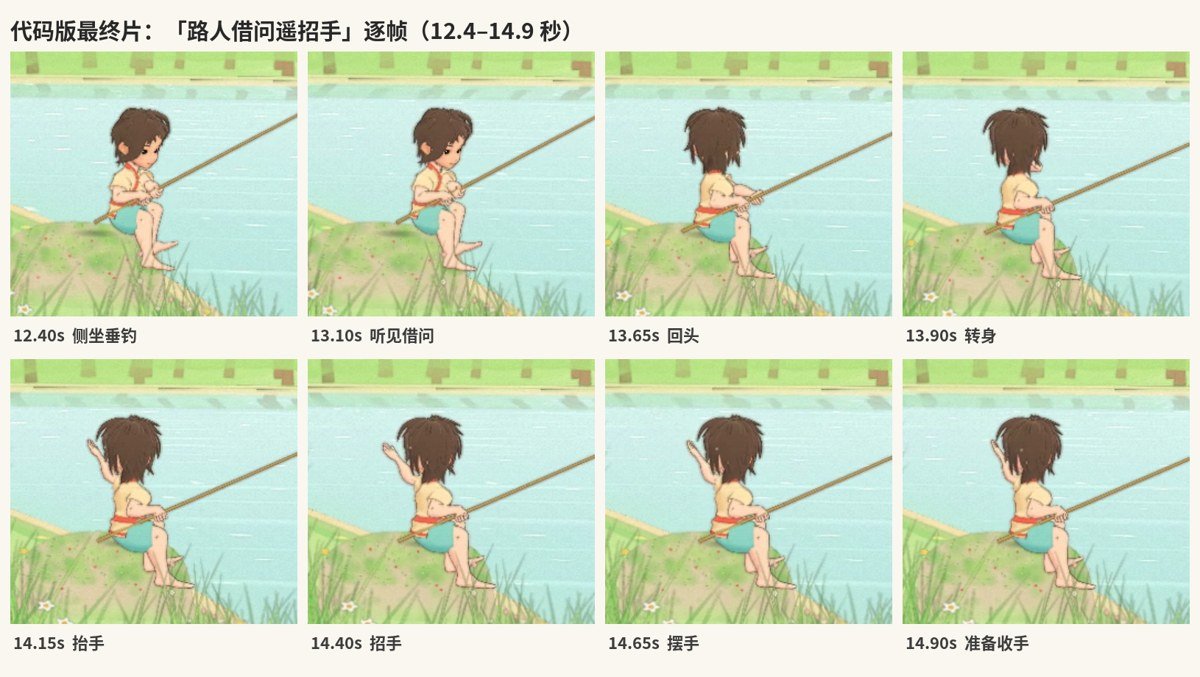
代码版:3D 骨骼"遥招手"10 帧序列,逐帧核对
成片 22.6 秒,CPU 软渲染 565 帧,跑了十几分钟。它不完美,,但它是第一个我看完不用挑大毛病的版本。
踩过的坑怎么解决,可以直接抄
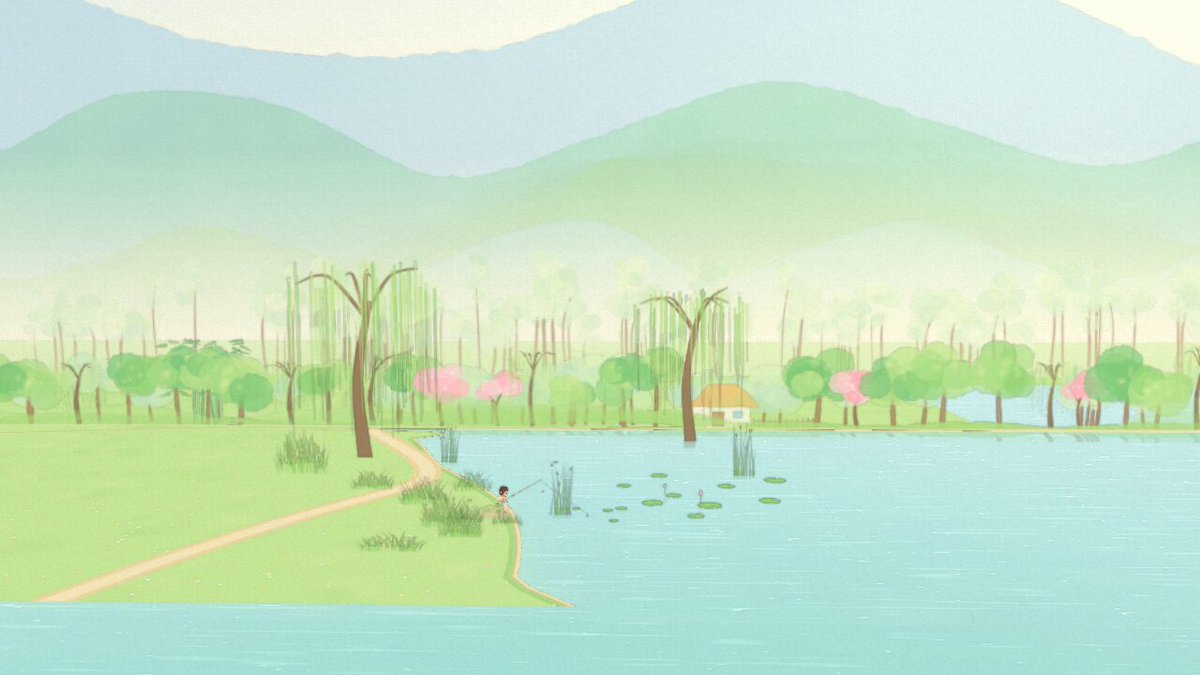
代码版成片,待补背景乐
- 先锁音轨,再做画面。 反过来做,最后只能拿慢放去凑。
- 整段朗诵一次生成。 一句一生成,声音必然不统一。
- 别指望模型记住道具。 鱼篓、衣服颜色、草的位置,每重新生成一次就可能变一次。
- 手是重灾区。 我经历了一整条链:畸形手 → 裁掉藏起来 → 关键动作跟着丢了。
- 模型会自己往画面里加字。 生成完要先查有没有乱字幕。
- AI 看不了完整视频,就别让它说"通过"。 第一次全程只能抽关键帧、测音高、跑语音识别,"听感"那一栏永远写着未验证,结果我成了验收员。后来定了规矩:交付前按清单逐项自查,已知不达标的不许发给我。
- 需求写成能验证的数字。 "招手对上字音""画面明亮"这种话,写成"手在 14.10 秒前抬起""关键帧平均亮度不低于 190",审稿才有抓手。
- 别让 AI 凭空用代码画人。 先要一个结构正确的底子,现成的骨骼模型或一张确认过的定妆图,再用代码去驱动。没有底子,审稿意见只能变成一条条补丁。
- 改脸先定参考和比例。 别在原模型上局部推拉网格;用完整的成品五官,先出大头特写确认,再缩到最终尺寸看五官清不清楚。
额度为什么烧得这么多
先说两次真实的"额度告急"。
第一次是做模型版那周。11 月 7 日折腾了一整天,第二天早上一看,周额度只剩 10%,离重置还有 3 天。我在 X 上发帖问"怎么办",最后还是提前两天把额度用完了。后台的统计也对得上:过去 7 天的 Bot 用量里,11 月 7 日一天就占了 40%。
第二次是这周。额度刚重置两天,就被我用到了 48%,我是在回别人帖子的时候顺口说的。其中做代码版古诗视频那天,一天就吞了 15% 的周额度。
我复盘下来,原因有三层:
第一,模型路线的改动不能累积。 每次重新生成都是重新抽签,修好草,衣服变色了;修好衣服,手又不对了。花出去的额度大部分没留下东西。
第二,验证缺位会放大浪费。 看不了完整视频,就只能抽帧、猜、再生成。盲改的每一轮都是真金白银。
第三,代码路线也不便宜,但钱花在了收敛上。 人物从木偶改到 3D 骨骼、脸改了好几版,前面两个坑都烧了不少。区别是每次修改都是一段代码 diff,改了就留住了,下一首诗还能接着用。
还有一点是事后才想明白的:第二次能一天半做出来,是踩在第一次的遗产上,那条 take-e 音轨、那份要求清单、那张验收表,都是第一次烧出来的。第一次的额度不算白花,它买到的是需求。
接下来:Codex 写代码,Bot 只指挥
分工这样定:
- Bot:拆诗、写分镜脚本,把我的要求翻译成验收标准,审关键帧,记住我纠正过的每一条。
- Codex:在仓库里写渲染代码、跑渲染、修 bug。
理由也简单:
- 代码版本质上是个软件工程,长时间"写-跑-改"的循环,本来就该交给编码 Agent。
- 写的和审的分开。改代码的不自己判通过,审稿的不动代码。
- 额度分开。Bot 的周额度和我其他应用共享,拿来跑长时间渲染调试太贵; Codex 订阅的 100pro ,应该是够用的。
- 项目已经是可复用的骨架:换一首诗,主要改音轨时间轴、镜头表、布景和诗题。后面准备在课本中再挑两首来尝试。对比一下Codex和Bot的审美差异。
最后想问问
做儿童内容的朋友,你们现在是直接用视频模型出片,还是也回到了代码或动画工具?有没有人找到了让角色和道具稳定不变的办法?评论区聊聊。