已发布 · 2026-11-03 14:50(上海时间) · 原文链接
我是红宇,使用Laravel框架 的程序员,最近开始做 AI 自媒体。
这两天我尝试了一件事:用 AI 给二年级小朋友做语文课文讲解视频。第一集选的是统编版二年级上册的《我是什么》,成片 1 分 54 秒,15 个镜头。
先说清楚:这不是真动画,是"插画 + 配音 + 轻微推拉镜头 + 字幕"拼出来的图片视频。但作为第一版 demo,我觉得还是不错的——孩子能看懂,课文内容没跑偏,整个流程能复用到后面每一课。
这篇文章我把全部过程、每一步怎么做、用的配置和提示词都公开出来。也会老实列出现在的毛病。
一、先看整体流程
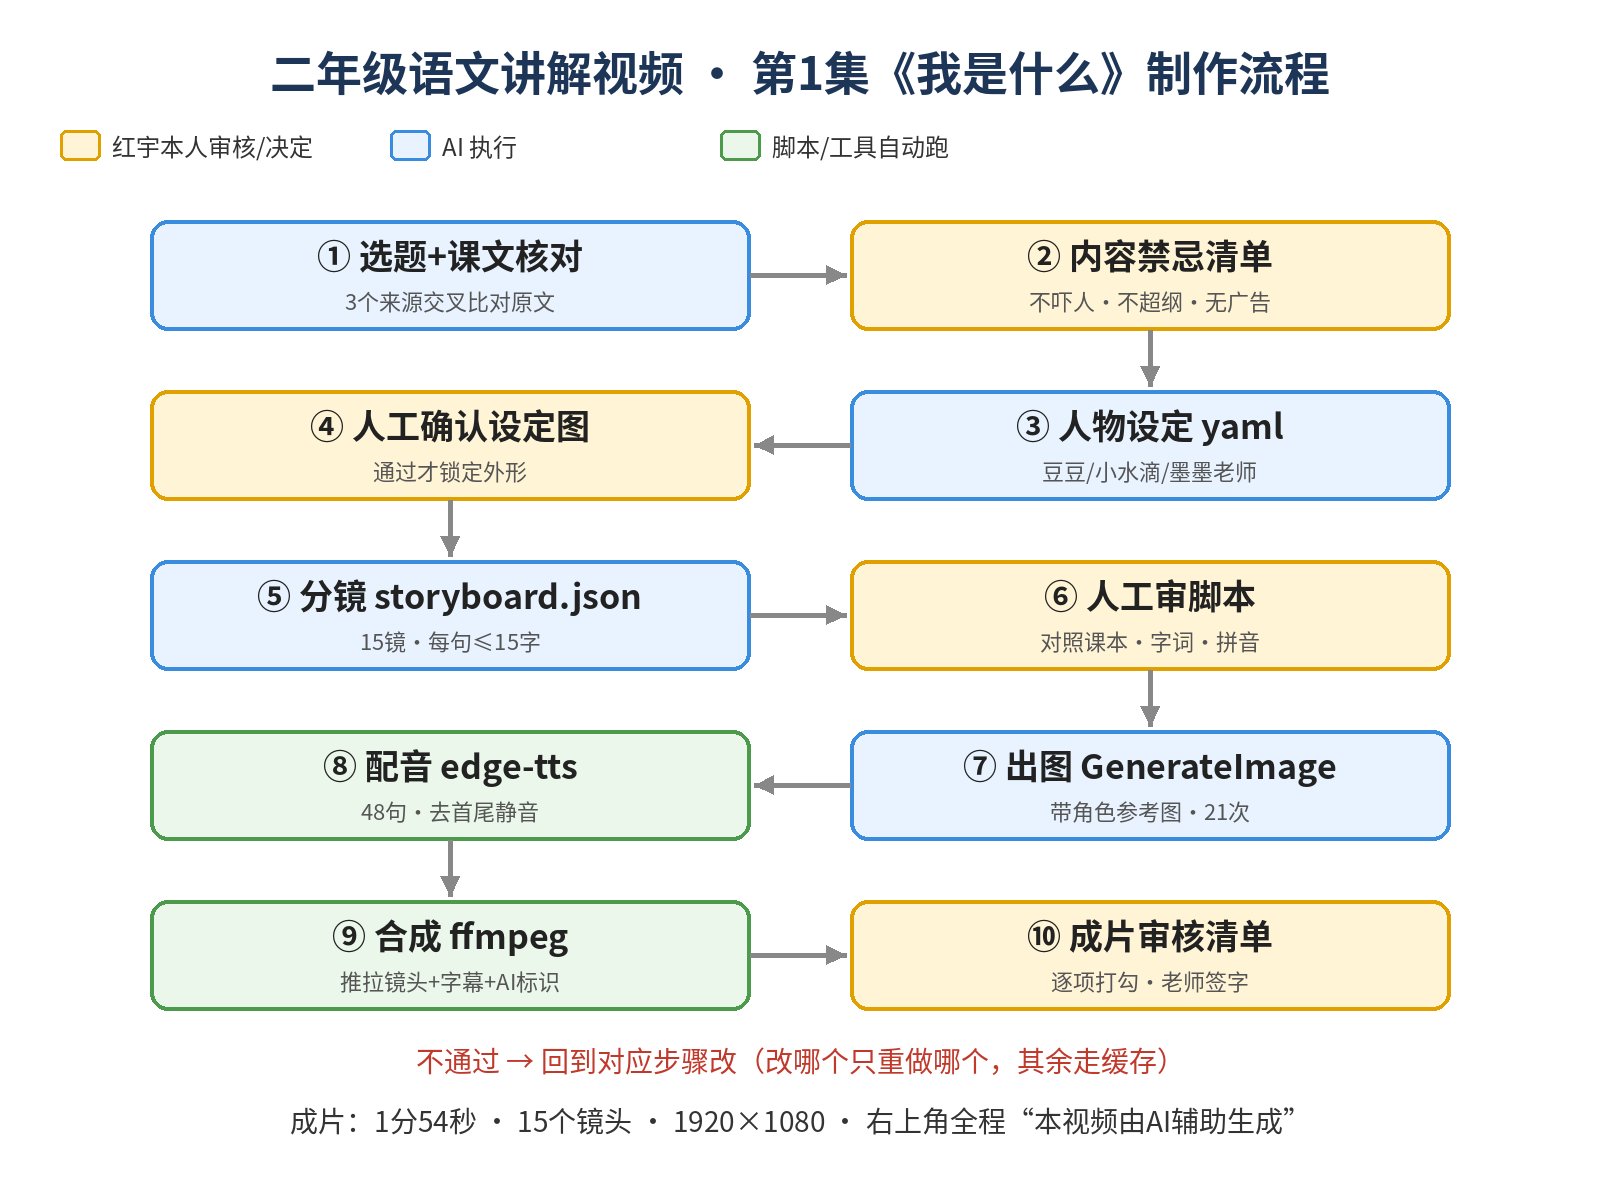
一句话:AI 负责写脚本、画分镜、出图、配音、合成;我负责定规矩、审内容、审人物。
图里黄色是我自己必须把关的节点,蓝色是 AI 干的,绿色是脚本自动跑的。哪一步不通过,就退回那一步改,其它没变的部分直接复用(后面讲"缓存"是怎么回事)。
系列规划:
-
先做语文(统编/人教版二年级),用固定的几个角色"讲故事"。
-
后面做数学(北师大版),用 Manim(一个用代码画数学动画的工具)做动画。
-
角色可以换,改一个配置文件就行。
二、选题与课文核对(最重要的一步)
给孩子看的东西,第一条是内容不能错。
我本来想从一个电子课本网站取原文,结果抓取时网站返回错误(HTTP 500),拿不到。于是换成三个来源交叉核对:
- 百度百科《我是什么》
- 汉查查电子课本
- 人教版二上课本 PDF(带拼音,含课后题"说说'我'是什么,'我'会变成些什么")
三处原文一致。课文要点:太阳一晒→汽;升到天空连成一片→云(白衣服/黑衣服/早晨傍晚披红袍);越升越高→雨;小硬球→冰雹;冬天小花朵→雪;平常在池子里睡觉、小溪里散步、江河里奔跑、海洋里跳舞唱歌;做好事也做坏事,人们想办法管住"我"。
视频里做的改写只是把句子变短,不改事实: - "极小极小的点儿" → "极小的点儿" - "光做好事,不做坏事" → "只做好事" - "体温越来越低" → "越来越冷"(口语化) - 加了一句"'我'一直在转圈旅行",这是课文之外的轻度拓展(水循环),需要老师判断是否超纲。
三、内容禁忌:先把"不能做什么"写下来
我是从一个二年级学生的角度来写内容的。在让 AI 动手之前,我先定了一份禁忌清单,写进人物配置和审核清单里:
- 不做危险动作,不独自去水边(豆豆的规则)
- 不出现恐怖表情、恐怖画面
- 不贬低他人,不歧视
- 没有品牌、广告
- 不说"必考"之类的焦虑话术(墨墨老师的规则)
- 不画真实地图、不画国旗
- 课文里"淹没庄稼、冲毁房屋"只在台词里出现(这是课文原话),画面不画洪水,用平静的河堤、植树代替
- 冰雹镜头里,豆豆是在屋里隔着窗户看的
- 全程右上角标"本视频由AI辅助生成"
四、人物设定与一致性
三个角色(v0 草稿,还没锁定):
| 角色 | 定位 | 配音音色 |
|---|---|---|
| 豆豆 | 8 岁二年级男孩,负责提问,黄帽子+绿本子 | edge-tts zh-CN-YunxiaNeural,语速 -5% |
| 小水滴 | 课文里的"我",浅蓝水滴,顶部小卷,粉脸蛋 | zh-CN-XiaoyiNeural,语速 -8% |
| 墨墨老师 | 小猫头鹰老师,第一集只出声音 | zh-CN-XiaoxiaoNeural,语速 -10% |
所有设定都在一个文件 config/characters.yaml 里。改人物只改这里。比如小水滴:
shuidi:
  name: 小水滴
  personality: [爱变化, 爱旅行, 温和]
  catchphrase: 猜猜我是谁?
  look_prompt: >-
    a cute anthropomorphic water droplet character, translucent light-blue teardrop body
    with a soft white highlight, small curl on top, big round shiny black eyes, rosy cheeks,
    tiny smile, tiny stubby arms, no legs, glossy, children's picture-book style
  palette: {body: "#8FD3FE", highlight: "#FFFFFF", cheek: "#FFB6C1", outline: "#3A8DDE"}
  locked_features: [水滴外形, 顶部小卷, 浅蓝色, 粉色脸蛋]
  voice: {engine: edge-tts, id: zh-CN-XiaoyiNeural, rate: "-8%", pitch: "+0Hz"}
  rules: 变成云/雨/雪时仍保留眼睛与脸蛋以便识别;不出现恐怖表情
说人话解释几个字段: - look_prompt:给生图 AI 的"长相描述",英文写效果更稳。 - palette:角色固定用哪几个颜色(HEX 色号)。 - locked_features:审核通过后不能再改的特征。 - voice:用哪个声音、语速多少。
怎么保持人物长得一样? 先让 AI 生成每个角色的"设定图"(白底三视图 + 几个表情),我确认后,之后每个镜头出图时都把这张设定图当参考图一起喂进去。
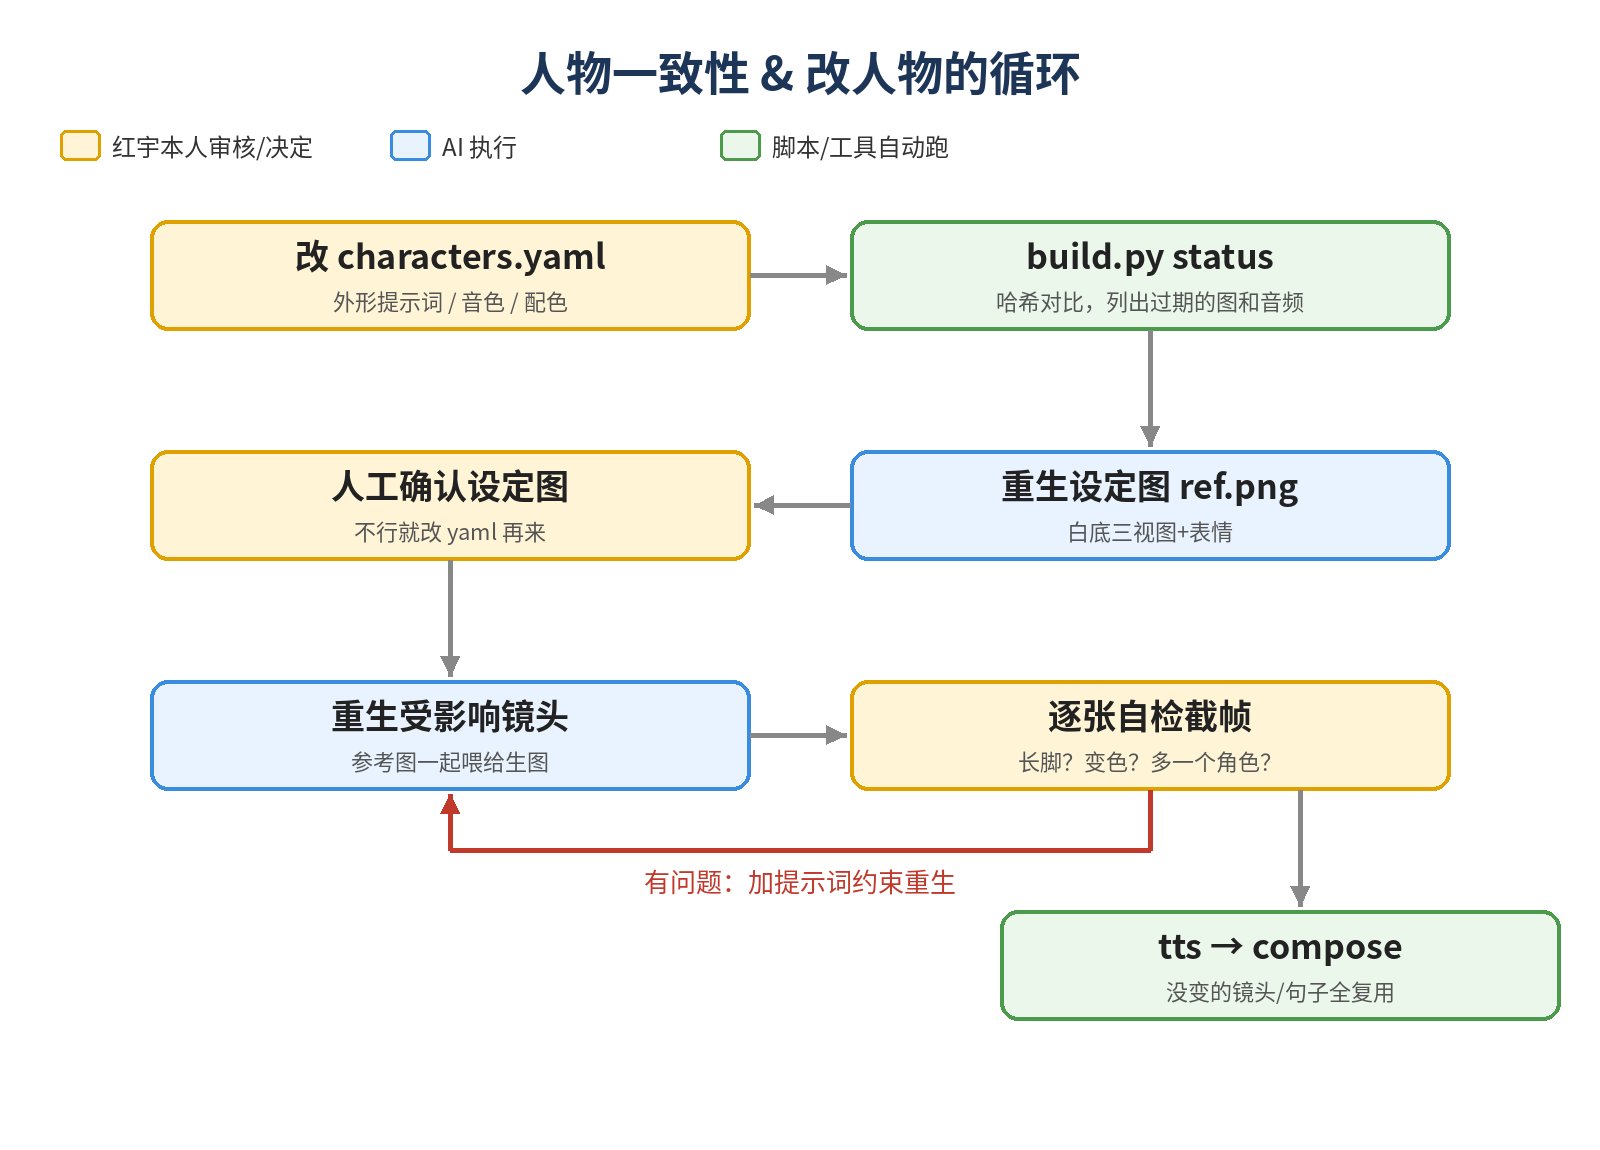
改人物的流程(比如把豆豆换成女孩果果):
-
改 characters.yaml 里的外形或音色;
-
跑 python3 scripts/build.py status,脚本会对比"指纹"(哈希,可以理解成内容的唯一编号),告诉我哪些图和音频过期了——改外形,这个角色的设定图和所有有他出场的镜头都过期;只改音色,只需要重配他的台词;
-
重生设定图,我确认; 4. 重生受影响的镜头; 5. 重新配音、合成。没受影响的全部复用。
五、脚本
脚本由 AI 根据课文写,规则: - 每句不超过 15 个字(脚本自动检查,最长正好 15 字) - 整集只围绕一个核心问题:"'我'到底是谁?" - 屏幕上的大字只用简单字,难字加拼音:汽 qì、云 yún、雨 yǔ、冰雹 bīng báo、雪 xuě
结构是这样设计的: - 开头用谜语:小水滴说"小朋友,我会变!猜猜我是谁?" - 中间暂停:墨墨老师问"汽、云、雨、冰雹、雪,它们是同一个'我'吗?",然后停 3 秒,屏幕倒数 3-2-1,让孩子自己想。 - 结尾留问题:"考考你:雪化了,会变成什么?告诉爸爸妈妈吧!"
全集 48 句台词,391 个字。
六、分镜
分镜放在 storyboard.json,每个镜头写清楚:编号、时长、画面描述、出场角色、台词(谁说的)、屏幕字。例如第 1 镜:
{
  "id": "s01",
  "scene": "sunny park after rain, a small puddle on the grass path, boy kneeling and looking curiously at the puddle, droplet character peeking out of the puddle waving",
  "characters": ["doudou", "shuidi"],
  "lines": [
    {"speaker": "shuidi", "text": "小朋友,我会变!"},
    {"speaker": "shuidi", "text": "猜猜我是谁?"},
    {"speaker": "doudou", "text": "咦?你是谁呀?"}
  ],
  "onscreen": "猜猜我是谁?"
}
15 个镜头顺序:谜语开头 → 汽 → 云(2 镜)→ 雨 → 冰雹 → 雪 → 暂停想一想 → 旅行地图(池子/小溪/江河/海洋)→ 转圈旅行 → 做好事 → 管住我 → 揭晓"我是水" → 总结+结尾提问 → 再见。
台词脚本 script.md 是从分镜自动导出的,我审脚本时看这个就行。
七、出图
每个镜头的提示词 = 画面描述 + 出场角色的长相描述 + 统一画风 + "不要文字"。统一画风写在 config/style.yaml:
art_style: >-
  warm gentle children's picture-book illustration, soft watercolor and gouache texture,
  pastel colors, rounded shapes, soft lighting, friendly and safe mood,
  absolutely no text, no letters, no words, no logos, no brands in the image
aspect_ratio: "16:9"
resolution: [1920, 1080]
为什么要"不要文字"?因为 AI 画字经常画错,字一律后期用字幕加。
操作步骤: 1. python3 scripts/build.py gen_shots 生成一份待出图清单(含提示词和参考图路径); 2. AI 逐条调用生图工具(Grok Bot 内置的 GenerateImage),把该镜所有出场角色的设定图作为参考图传进去; 3. python3 scripts/build.py import shot:s05 /path/img.jpg 登记图片,自动裁成 1920×1080。
这次一共 21 次生图:3 张设定图 + 15 张镜头 + 3 张重做,大约 10 分钟。
八、配音
用的是免费的 edge-tts(微软的在线语音合成,不用密钥,需要联网):
bash
pip install --break-system-packages edge-tts pyyamlpython3 scripts/build.py tts
每句台词按"文字 + 音色 + 语速 + 音调"算一个指纹缓存,改了哪句只重配哪句。
一个关键处理:edge-tts 每句前后自带 0.3–0.5 秒静音,第一次合成出来成片有 2 分 39 秒,太拖。我用 ffmpeg 把每句首尾静音切掉:
bash
silenceremove=start_periods=1:start_threshold=-45dB,areverse,silenceremove=start_periods=1:start_threshold=-45dB,areverse,afade=t=in:d=0.03
(意思:去掉开头静音 → 倒过来 → 再去掉开头静音(其实就是原来的结尾)→ 再倒回来 → 加 0.03 秒淡入防止"啪"的一声。)句子之间统一留 0.35 秒,成片变成 1 分 54 秒。语速大约每分钟 190–200 字。
九、字幕与合成
全部用 Python + ffmpeg,一条命令:
bash
python3 scripts/build.py compose # 输出 out/ep01.mp4
它做了这几件事: 1. 片头片尾卡:用首/末镜的模糊图 + 思源黑体(Noto Sans CJK)写标题。 2. 每个镜头"动起来":用 ffmpeg 的 zoompan 做 Ken Burns 效果(就是纪录片里常见的照片慢慢推近/拉远),奇偶镜头交替推近、拉远,缩放 1.0↔1.12。 3. 配音拼接:每句音频按时间点放进去,句间 0.35 秒,镜头结尾留 0.6 秒,暂停镜头额外 3 秒。 4. 字幕:生成 ASS 字幕(一种可以设颜色、位置的字幕格式),说话人不同颜色;屏幕大字顶部居中黄色描边;倒数数字;右上角常驻"本视频由AI辅助生成"。 5. 文件里也写标识:元数据写入 "AIGC: 本视频由AI辅助生成"。
合成大约 1 分钟。全片零费用(生图用 Grok Bot 内置额度,配音免费)。
十、审核
我设了三个人工审核点: - 审核 1(脚本):对照课本原文核字词、拼音; - 审核 2(设定图):确认后锁定外形; - 审核 3(成片):按清单逐项打勾,最后老师签字。
成片审核清单(AI 先自检一遍,再由人复核):
| 项目 | 结果 |
|---|---|
| 知识点与教材对应、无超纲 | ✅ 与课文一致;⚠ "转圈旅行"是轻度拓展;⚠ 2025 修订版未核纸书 |
| 读音/拼音 | ✅ 屏幕拼音已核;⚠ 配音里"冰雹"要人工听一遍 |
| 字幕无错别字 | ✅;台词里的"灌溉""暴躁"没标拼音,需老师决定 |
| 角色外形一致 | ⚠ 基本一致,有两处问题(见下) |
| 无危险/恐怖画面 | ✅ |
| 无品牌广告、焦虑话术 | ✅ |
| AI 生成标识 | ✅ 画面右上角 + 文件元数据 |
| 时长 1–3 分钟、有提问和停顿 | ✅ |
| 老师签字 | ☐ 待签 |
十一、踩坑记录
| 问题 | 怎么解决的 |
|---|---|
| 雨的镜头,小水滴身上长出"钥匙扣链子" | 提示词加 "floating freely… nothing attached to them" 重画 |
| 暂停镜头图片左右有白边 | 提示词加 "Full-bleed… no borders" 重画 |
| 旅行地图上下有白边 | 导入前裁掉上下各 6%、左右各 3% |
| 结尾镜头出现两个小水滴 | 提示词写明 "Exactly two characters… ONE single droplet" 重画 |
| 第一次成片 2 分 39 秒太长 | 切掉配音首尾静音,句间统一 0.35 秒 → 1 分 54 秒 |
| 倒数"3-2-1"压在豆豆脸上 | 挪到画面右侧 |
| 课本网站抓取报错 | 换三个来源交叉核对 |
十二、视频点评与改进建议
做完后我自己从头到尾逐段看了一遍,说说真实感受。
逐段点评:
- 0:00 片头《"我"到底是谁?水的七十二变》:开场谜语钩子挺强。小水滴画得不错,就是一颗没有手脚的蓝色水滴,符合设定。
- 0:09–0:28 汽和云:节奏舒服。白云、灰云、粉红的云,正好对上课文的"白衣服、黑衣服、披红袍"。
- 0:29 雨:白色字幕没有底色,压在草地和雨上看不太清。
- 0:37 冰雹:配音里"冰雹"的读音要人工听一遍。我查了配音文件,这句是直接把文字"人们叫我冰雹。"交给 edge-tts,没有做任何读音标注,所以有没有读成 bīng bāo,只能靠耳朵确认。
- 0:47 3-2-1 暂停思考:想法是对的,但只是在静态图上跳出数字;而且 3 秒对 7 岁孩子太短,我觉得应该改成 5 秒。
- 0:59 旅行地图:小水滴长出了腿和脚,颜色也偏青绿,跟前面不连贯。
- 1:08–1:29 水循环、做好事、发洪水:比喻是好的,但长段旁白配一张不动的图,会拖。
- 1:30 "你是水!":本该是"啊哈"时刻,但画面没动、没音效,只是硬切或叠化,有点平。
总体:画面可爱,适合这个年龄段;但看起来更像一本"有人念的绘本",配音也有点机器味。另外要说明:这一版没有背景音乐(配置里写的是 bgm: none,成片里只有配音这一条音轨)。
改进建议(按优先级):
- 让画面动起来:关键镜头用图生视频;现在已有轻微推拉(缩放 1.0↔1.12),可以加大幅度、加上平移。
- 角色一致性:每次都带设定图做参考,并在提示词里明确写"no legs, no feet"这类反向约束。
- 修读音:用 SSML(一种给语音合成加读音、停顿标注的标记语言)或读音覆盖指定"雹"读 báo;或者换一个更有讲故事感的声音。
- 升级暂停思考:改成 5 秒,加滴答声,汽、云、雨、冰雹、雪一个一个出现。
- 字幕:更大的圆体字,下面垫一条半透明底条。
- 音效:汽升起的"呼"、雨声、冰雹"叮叮"、揭晓答案时"嗒哒~"。
- 生字动画:屏幕大字弹跳出现,拼音高亮。
- 主题转场:水花擦除、云朵"噗"一下的转场。
十三、下一步:怎么做出动态演示
图片视频只是起点。我的思路是混合流水线:不是每个镜头都要 AI 视频,按需分档。
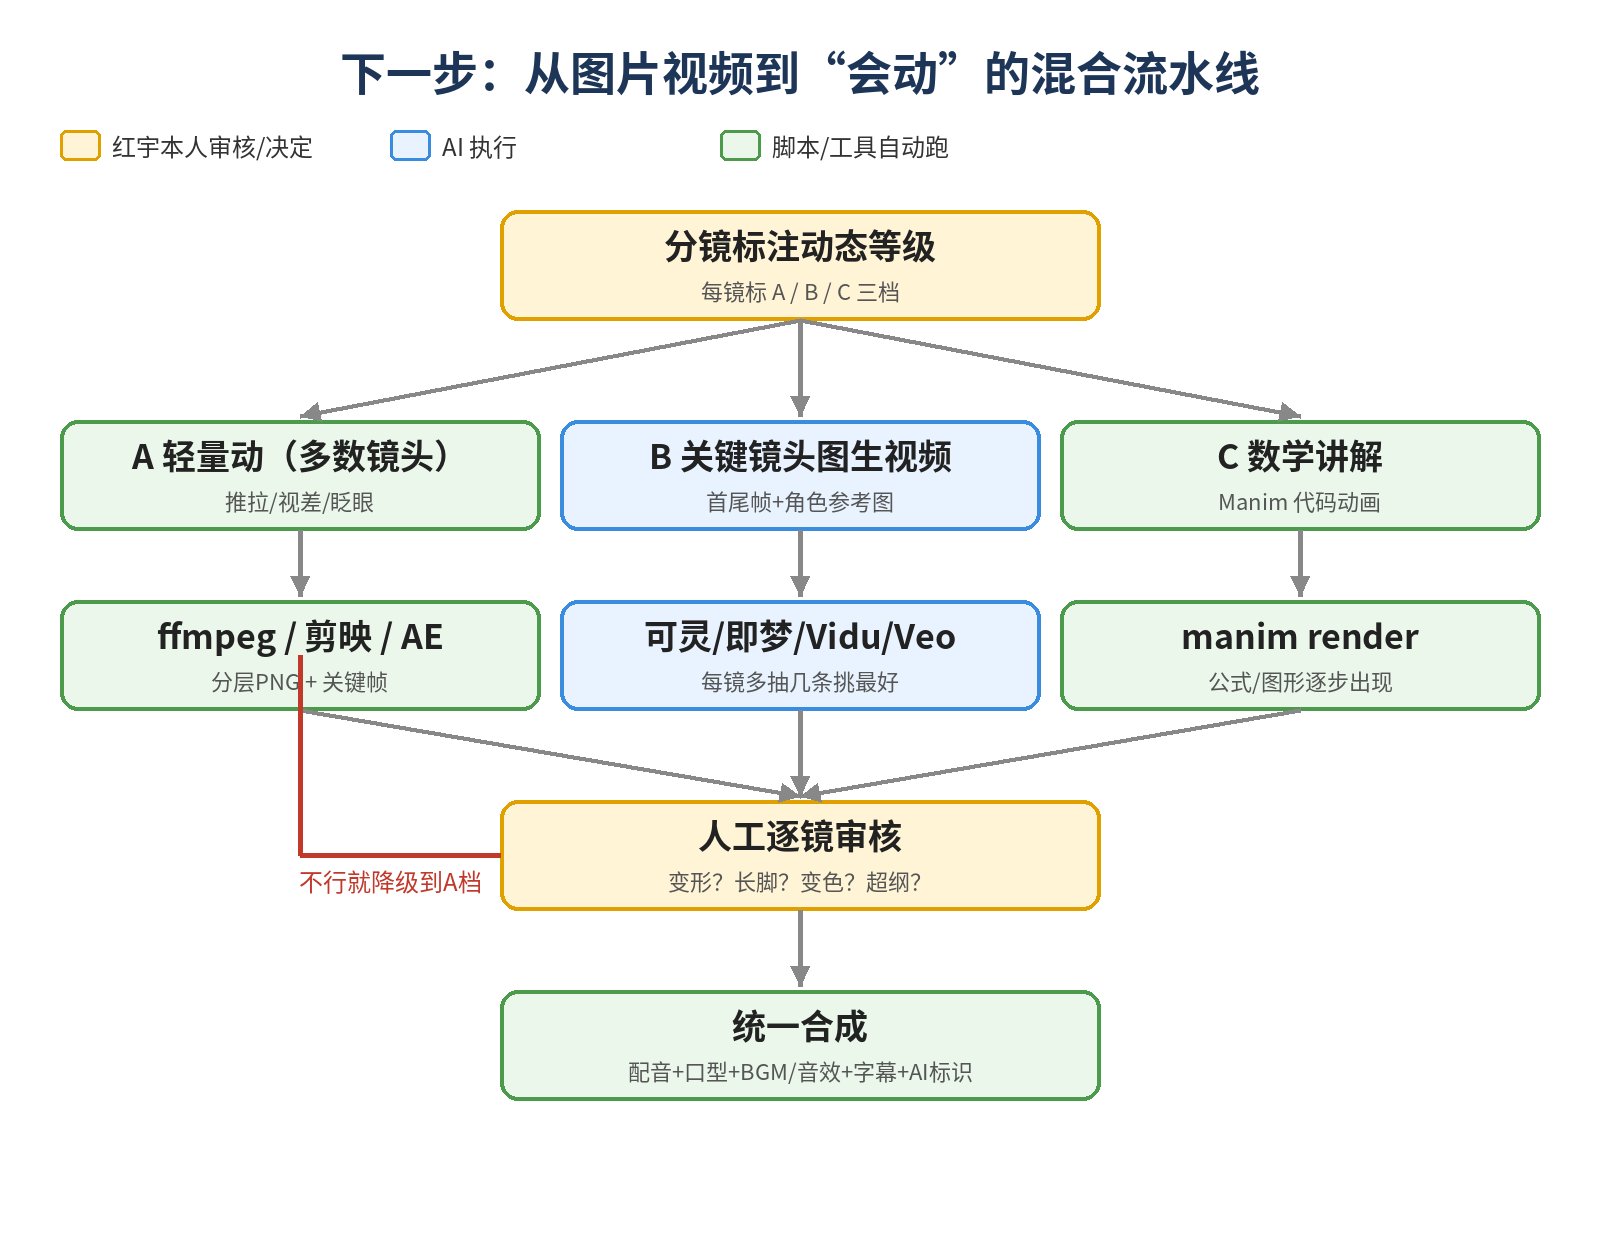
A 档:轻量动(大多数镜头)- 现在的 Ken Burns 推拉 + 平移; - 视差:把角色和背景拆成分层 PNG,前后层移动速度不同,就有了纵深感; - Live2D 式小动作:眨眼、身体轻轻晃、嘴巴一张一合。可以用 ffmpeg 脚本做,也可以用 After Effects 或剪映的关键帧。 - 优点:便宜、可控、角色绝不变形。缺点:动作幅度有限。
B 档:关键镜头用图生视频- 用现有插画当首帧,让 AI 生成几秒视频。我查了目前的主流选择:可灵(快手,Kling 3.0 / 4.0)、即梦(字节,Seedance 系列)、Vidu(生数科技,Q3 等)、Google Veo 3.1、Runway Gen-4.5、阿里通义万相 Wan 2.7。 - 首尾帧控制:给"开始那张图"和"结束那张图",让 AI 补中间过程。比如"水滴 → 汽"、"云 → 雨",这种变化特别适合。Vidu、Veo 3.1、可灵、万相 2.7 都支持首尾帧(各家具体限制以官方文档为准,比如 Veo 3.1 的首帧和参考图不能同时用;Runway Gen-4.5 图生视频是给一张首帧)。 - 角色参考图:Vidu、Veo 3.1 等支持传角色参考图来锁定长相。 - 实操:每个镜头多生成几条挑最好的;不行就退回 A 档。 - 成本:按秒计费,比图片贵得多,所以只用在"变化"和"揭晓"这类关键镜头上。
C 档:数学用 Manim- 数学(北师大版)用 Manim 写代码出动画:数字、图形、算式一步步出现,绝对准确、风格统一。
口型:角色说话时嘴要动。轻量做法是 A 档的张嘴/闭嘴两帧按音量切换;也有图生视频模型支持"上传音频驱动口型"(比如万相 2.7 的文档里写了首帧+音频驱动口型同步)。
声音:加无版权轻音乐 BGM 和音效(雨声、雪花"叮");配音可以升级到 GPT-SoVITS、CosyVoice 这类能固定音色、控制情感的方案。注意:克隆真人声音必须有书面授权。
时间和成本的取舍: - 全 A 档:几乎零成本,一集合成几分钟,但"动"得有限; - A + 少量 B:只给 3–5 个关键镜头用图生视频,成本可控,观感提升最明显——这是我准备走的路线; - 全 B 档:最像动画,但贵、慢,角色一致性也最难保证。
十四、v1 不足与下一步
不足(老实说): 1. 小水滴在两个镜头里长出了小脚(设定是没有腿); 2. 海里的水滴朋友有些颜色偏绿; 3. 没有背景音乐; 4. "冰雹"的读音要人工确认; 5. 需要老师对照 2025 新版课本核一遍。
下一步: - 修掉上面的问题,出 v2; - 按 A + 少量 B 的混合流水线,把关键镜头做成真正会动的; - 第二课继续用同一套流程,验证"换一课只改分镜"能不能跑通; - 之后开数学,用 Manim。
结尾
一个 1 分 54 秒的图片视频,从核课文到成片,AI 干了大部分体力活,我把住了内容和人物两道关。离真正的动画还有距离,但作为第一版 demo,我觉得方向是对的。
想问问大家:如果你家孩子在上小学,你最希望下一集做什么内容?或者你觉得这种视频,孩子最在意的是画面会动,还是讲得清楚?评论区告诉我。