已发布 · 2026-11-15 12:47(上海时间) · 原文链接
11 月 13 日,DeepSeek 开放了「全家桶应用 API」,官方的原话是:开发者可以在自己的应用里实现复杂的对话功能,甚至 1:1 复刻出完整的 DeepSeek App。
很多人听完第一反应是:那是不是得自己接搜索引擎、爬网页、再做一层 RAG?
不是。官方构建 Chatbot 文档里,真正关键的是这一句:
搜索和阅读链接都由服务端完成。客户端只需要展示返回的内容块,并在下一轮把它们原样回传。
复刻的难点,不在再造一个模型,也不在再造一套搜索。难的是把网页端已经拆开的那些内容块,在自己的客户端里忠实渲染、完整保存、原样送回去。
本文按官方文档和开源演示客户端,把这条复刻路径理一遍。
先分清:你要复刻的是哪一层
DeepSeek 网页端和 App 里,用户看到的是一整套体验:思考过程、智能搜索、阅读链接、上传文件、引用角标、会话标题、语音输入和朗读。
现在这些能力已经进了 API。搜索会不会发起、打开哪些网页、页里找什么,都由模型自己判断,并在服务端执行。你的程序不必实现 search() 或 fetch(),也不必在客户端跑工具循环。
你要做的,是客户端这一层:
- 用流式请求把各段内容块收下来,画到界面上
- 把这些块连同加密字段一起存进会话历史
- 下一轮提问时,把历史原样放回请求里
官方还开源了一个演示客户端:在线试用,源码仓库。它是纯前端,浏览器直连 API,填入自己的 Key 就能用,也可以导入从 DeepSeek 网页端导出的历史对话。想 1:1 对齐官方体验,最省事的起点就是先跑通它,而不是从空白项目里重写一套渲染。
有一点要先说清:演示把 API Key 放在浏览器的本地存储里,只适合自己试用。如果要对外提供服务,Key 必须放在你自己的服务端,由后端去调 API。
选模型和协议
全家桶对话能力目前要求使用 deepseek-flash。旧名 deepseek-v4-flash 仍能调用,但模型已经切到 DeepSeek-V4.1-Flash-1017,并按 Flash 价格计费。
三条协议都通,选一条坚持用即可:
| 协议 | 接口 |
|---|---|
| Messages | POST https://api.deepseek.com/anthropic/v1/messages |
| Responses | POST https://api.deepseek.com/responses |
| Chat Completions | POST https://api.deepseek.com/chat/completions |
官方演示走的是 Anthropic 兼容的 Messages 和 Files API。如果你现有代码已经在用 OpenAI SDK,用 Chat Completions 也可以。Responses API 目前不支持用户元信息标记,也不支持「继续生成」,做完整 App 时这两处会卡住。
下面这条 Chat Completions 请求,是复刻官方对话的最小全集:开启思考、联网搜索、阅读链接、安全审核和会话标题,并且走流式。
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "thinking": {"type": "enabled"},
    "tools": [
      {"type": "deepseek_web_search"},
      {"type": "deepseek_read_url"}
    ],
    "safety_check": {"level": "high"},
    "title": {"enabled": true},
    "messages": [{"role": "user", "content": "DeepSeek V4.1 有哪些更新?"}],
    "stream": true
  }'
思考模式默认是打开的,强度默认是 high。也就是说,只要声明了 deepseek_web_search、又没主动关掉思考,你得到的就是「深度思考搜索」,不是普通联网搜索。
一次回答里,到底有哪些内容块
官方用一张网页端截图,把各块对应的位置标了出来。复刻 App 时,这张图就是界面说明书。
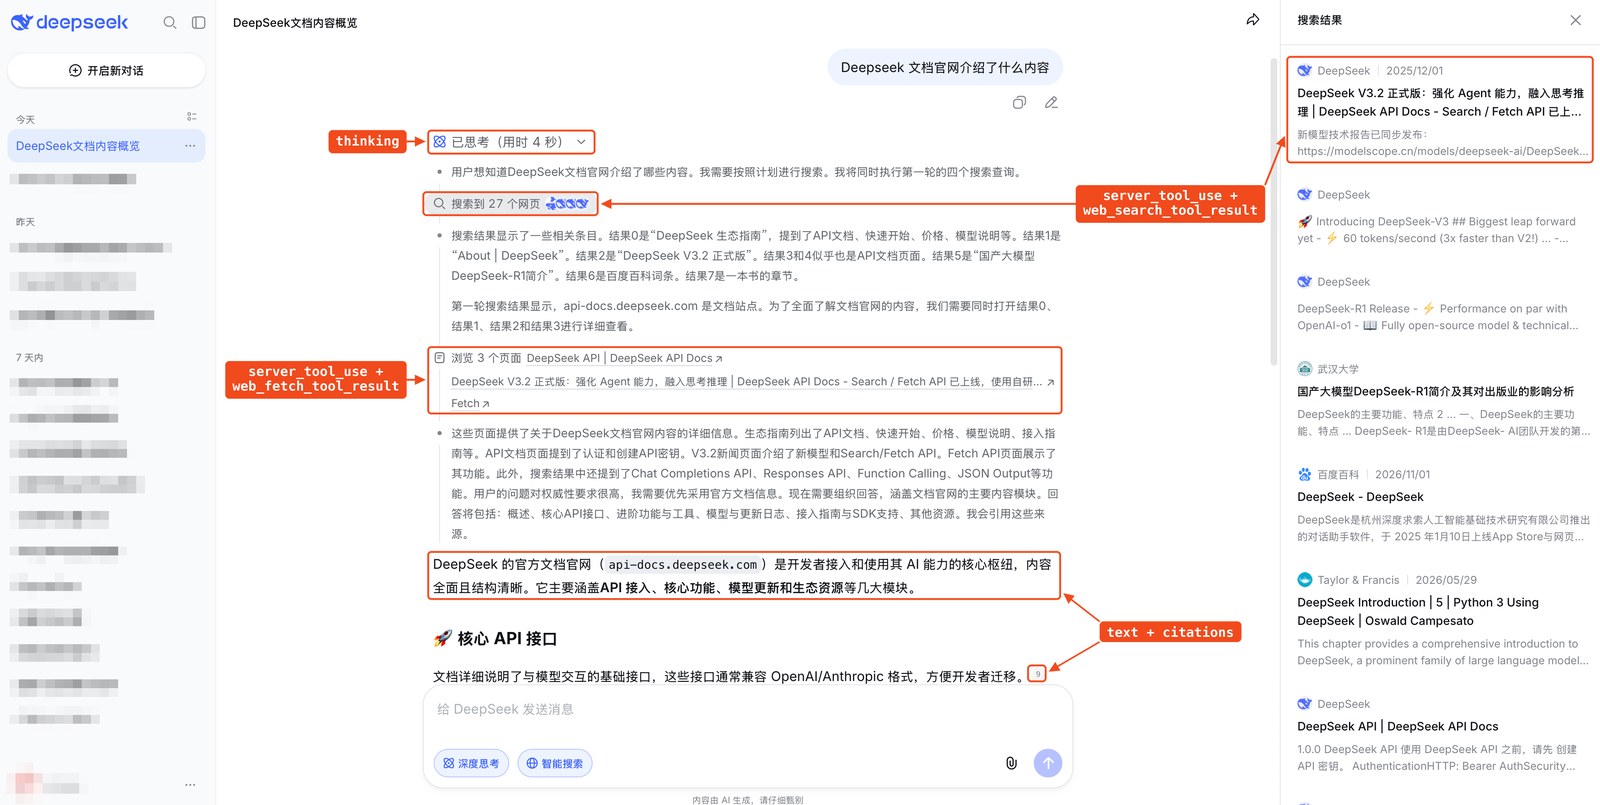
官方文档中的内容块对照。图源:构建 Chatbot
对照关系可以记成一张表:
| 内容块 | 界面上该怎么展示 |
|---|---|
thinking |
可折叠的思考过程 |
server_tool_use + web_search_tool_result |
一次搜索,以及结果卡片:标题、站点名、图标 |
server_tool_use + web_fetch_tool_result |
一次打开网页,或一次阅读用户给出的链接 |
带 citations 的 text |
回答正文,引用角标点进去是来源 |
stop_reason: "refusal" |
用你自己的拒答文案,替换已经展示出来的回答 |
流式响应是按块往下推的:先出现思考,再出现搜索或打开网页,最后才是带引用的正文。客户端要按块增量渲染,而不是等整段结束再一次性画出来。否则页面会长时间停在空白,和官方 App 的观感差很远。
核心原则:原样回传,尤其是 signature
普通多轮对话,DeepSeek 的 API 是无状态的:服务端不替你记住上下文,每次请求都要把历史拼接好再送回去。
上了全家桶之后,这条规则更严。你不能只回传最后的回答文本。上一轮里的思考块、工具调用块、结果块,以及结果里的 kind、signature,都要原样保存、原样回传。进不进下一轮上下文,由服务端决定,不要在客户端里自行精简。
这里有两个容易混在一起、但又必须分清的点。
没有携带 tools 时,历史里的思维链即使回传,也不会进入下一轮上下文,服务端只用各轮的回答正文。官方示意图是这样:
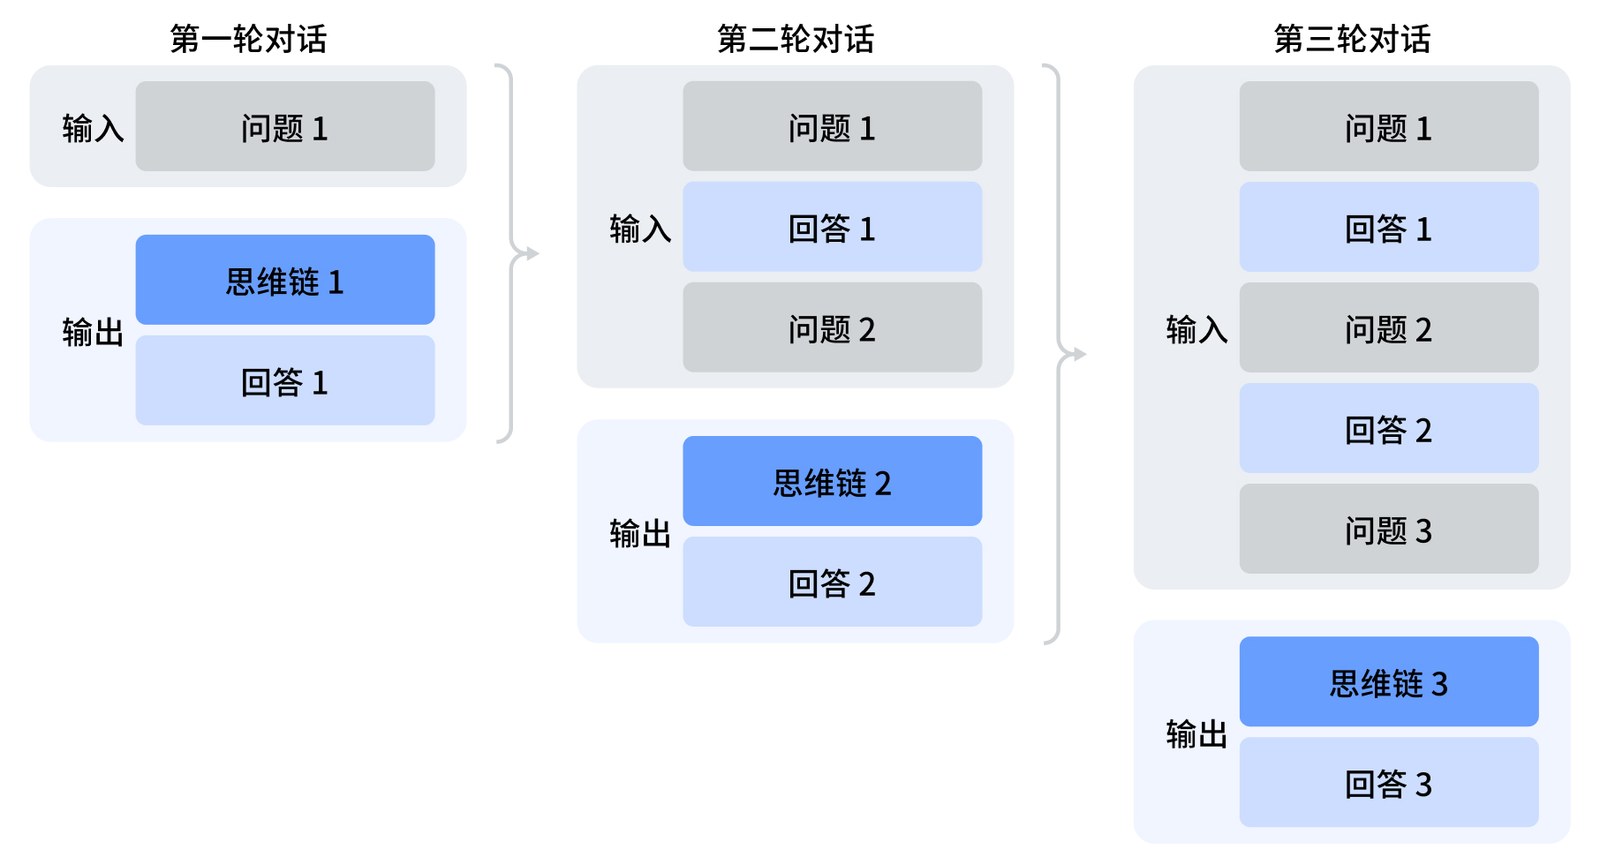
未携带 tools 时的多轮拼接。图源:思考模式
一旦请求里带了 tools,历史思维链就必须回传,否则可能直接返回 400。官方说明里写得很明确:即便某一轮模型并没有真正调用工具,也要完整回传。
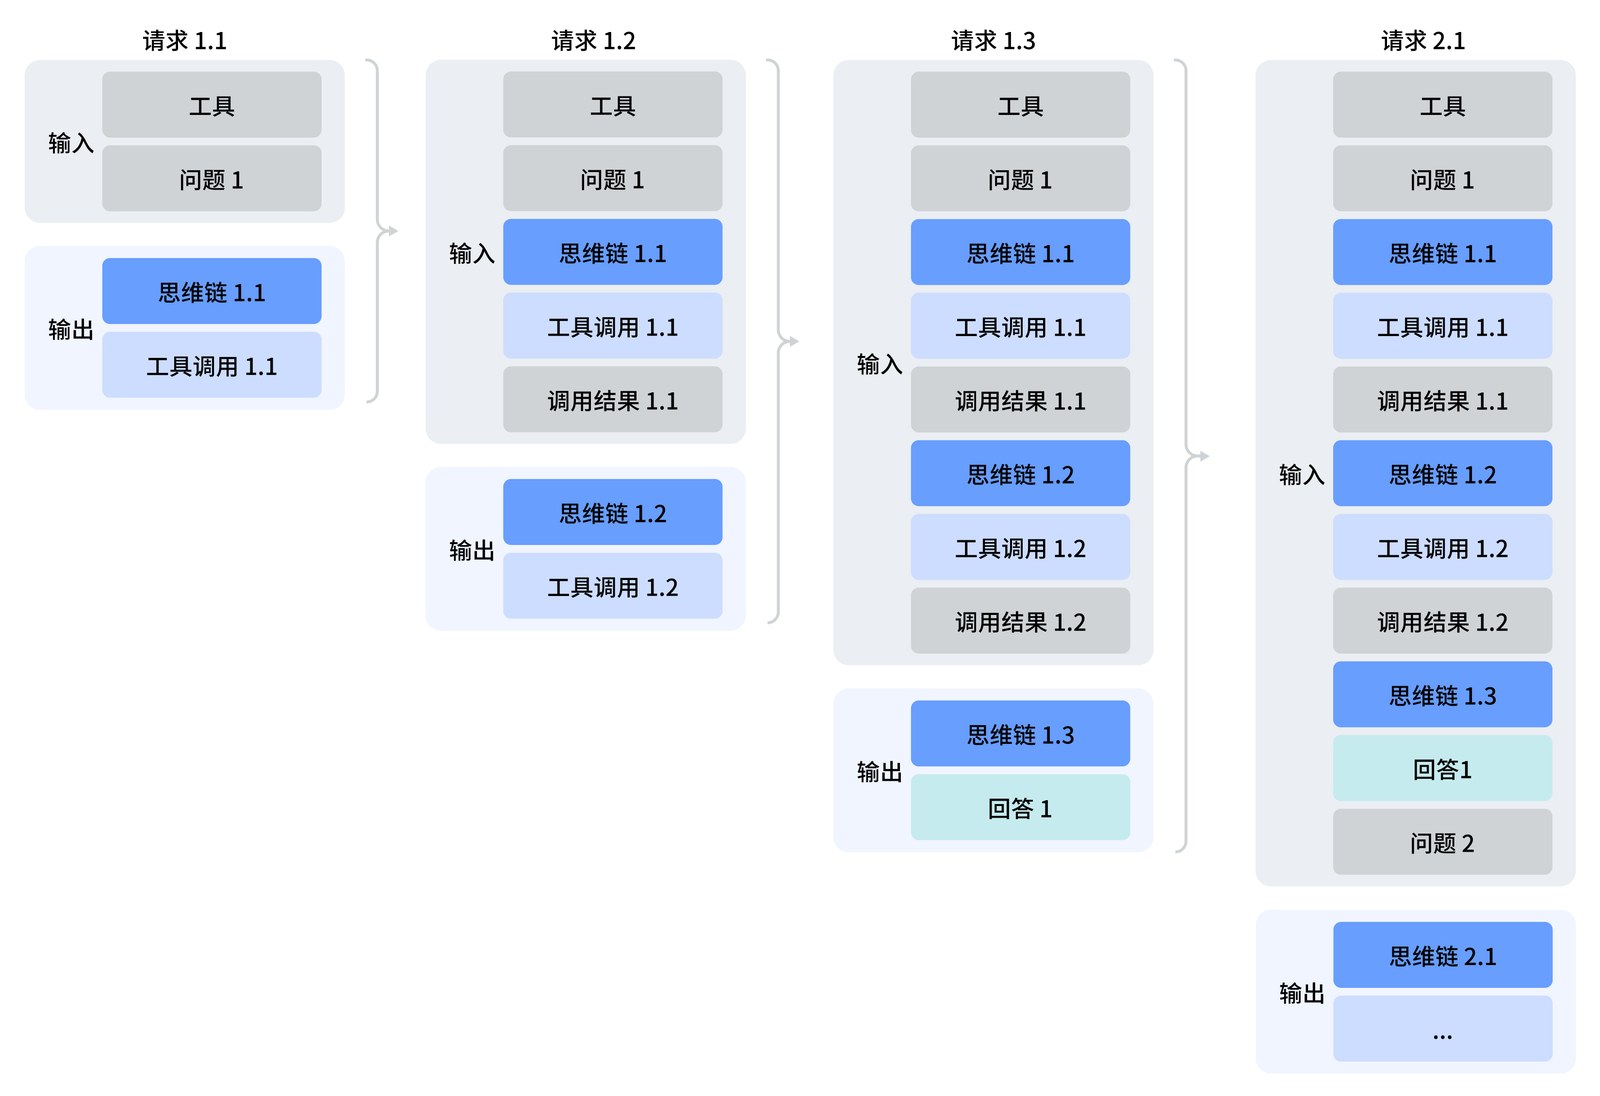
思考模式与工具调用的多轮回传。图源:思考模式
联网工具还有一层更细的处理:搜索结果、深度思考里打开的网页、以及此前的思考,默认不会进入后续上下文,只保留回答正文。但「阅读链接」读到的网页不同,正文不会明文出现在块里,而是加密放在 signature 中;你把这个块原样送回去,服务端才会把网页重新拼到该轮用户消息末尾。改了标题或把 data 填上自己抓的正文,都不会生效。丢掉 signature,这个网页就从后续对话里消失了。
所以存储会话时,不要只存「用户说了什么、助手回了什么」。正确的做法是把整段原始响应块当成历史的一部分。演示客户端把对话放在 IndexedDB 里,原因就在这里。
三种联网能力,其实是同一套工具的两种开关
| 能力 | 怎么打开 | 实际行为 |
|---|---|---|
| 联网搜索 | 声明 deepseek_web_search,关闭思考 |
模型按问题决定是否搜索网页或图片,并带引用作答 |
| 深度思考搜索 | 声明 deepseek_web_search,开启思考 |
模型在多步推理里自己搜索、打开网页、页内查找,边想边求证,大约最多 20 次工具调用后作答 |
| 阅读链接 | 声明 deepseek_read_url |
模型识别用户消息里的链接,抓取后再结合上下文作答 |
有几个细节,不做客户端也会在联调时撞上。
不能用 tool_choice 强制指定 deepseek_web_search 或 deepseek_read_url,否则返回 400。搜不搜、读不读,由模型判断。把 tool_choice 设为 none,会关掉全部工具,包括阅读链接。
「打开网页」和「阅读链接」不是一回事。深度思考搜索里的 open_page,打开的是模型自己搜到的页面;deepseek_read_url 读的是用户消息里给出的链接。开启思考并且同时声明了搜索工具时,本轮走深度思考搜索,不会再单独阅读链接。
阅读链接只认最后一条用户消息里的 URL,重复的只算一次,最多考虑前 10 个不同链接,由模型决定读其中哪些。同一轮读的链接越多,单个网页可用的长度越短,长文会被截断。
搜索一次可以带多个查询词,它们都列在 input.queries 里。计费时也是按查询词条数算,不是按「搜了一次」算。这个问题放到费用一节再展开。
如果你要在自己的 Agent 或 RAG 里手动搜索、抓取,应当使用独立的 Search / Fetch 接口,不要和对话里的联网工具混成一套循环。对话场景让模型自己决定即可。
文件是先解析,再引用
上传文件和官方网页端是同一套能力,分两步:先用 Files API 上传并指定解析方式,等解析完成拿到 file_id;再在对话的用户消息里引用这个 ID。不能在对话请求里直接塞文件内容或文件 URL。
解析方式只有两种,差别在于模型能不能看见文档里的图:
purpose |
模型拿到什么 | 更适合什么 |
|---|---|---|
text_recognition |
只有文字,图表和照片会被丢掉 | 合同、论文、扫描文字稿 |
rich_layout_recognition |
文字加上按原位置裁出的图 | 带图表的报告、幻灯片、有示意图的说明书 |
裁图会占用输入 Token,并计入每个请求的图片数量上限。不需要看图时,用纯文字解析就够了。文档里的图是自动识别的,不保证每张都能被裁出来;没裁到的图,模型仍然看不见。
curl https://api.deepseek.com/files \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -F purpose="text_recognition" \
  -F file="@report.pdf"
注意:purpose 必须写在 file 字段前面。解析完成前接口不会返回,客户端和中间代理的超时,要按「上传时间 + 解析时间」来设。中途断开连接,解析仍会跑完;成功的文件会保存并计费。原始文件和解析结果都不支持下载。
限制也要写进产品里:单文件最大 100 MiB、最多 1000 页,120 秒内传完,提交后 120 秒内解析完,每个账号同时进行的文档上传数为 15。每个对话请求最多引用 20 个文档,文字合计不超过 8 MiB;多轮里历史引用的文档会完整保留,超长直接 400,不会静默截断。
把 App 上的周边能力接上
这些看起来像「设置项」的功能,其实都有对应接口,少接一项,复刻出来的就不像官方 App。
用户元信息。 网页端会把当前日期、星期、所在地、平台和语言告诉模型,回答才会跟着「今天」「本地」走。API 里这条消息的角色是 latest_reminder,格式是:
plaintext
日期,星期,地点,平台,语言
例如:2026-11-15,星期日,上海,App,中文。它必须紧挨在所属的那条 user 消息前面。每一轮都可以带,历史里的也建议一起回传,不回传也能跑,但会降低上下文缓存命中。Responses API 暂不支持这条。链接写在这条消息里不会被阅读,也不影响是否搜索。
{
  "role": "latest_reminder",
  "content": "2026-11-15,星期日,上海,App,中文"
}
会话标题。 请求里打开 "title": {"enabled": true},回答结束时会顺带生成一个短标题,不必再单独请求,标题本身不计费。建议只在会话的第一次请求上打开,拿到标题就关掉。响应最多会为此多等 5 秒;被拒答或出错时可能没有标题,需要自己兜底,比如截取用户消息的前几个字。
语音。 朗读走 TTS:POST https://api.deepseek.com/v1/tools/tts,也可以用 WebSocket 边生成边播。目前文档里的音色是 stella(海星,女声,默认)和 tide(暗潮,男声)。语种按文本自动识别,没有单独的语种参数,也不支持调语速或中途打断后续传。filter_markdown 默认开启,适合直接朗读模型回答。识别走 ASR:POST https://api.deepseek.com/v1/tools/asr,一次上传完整音频,返回完整文本,不支持流式识别;音频最长 120 秒,最大 8 MiB,格式是 16 位 PCM WAV 或 Ogg Opus。
编辑、重新生成、继续生成。 官方演示里都有。继续生成的做法是:让消息列表以那条未完成的 assistant 消息结尾,响应只返回新生成的部分。Chat Completions 要走 beta 接口,并给最后一条助手消息加上 "prefix": true。用过联网工具的回复不能续写,会返回 400,只能重发上一次请求。Responses API 不支持继续生成。
安全审核可能在流式结束后才「翻盘」
对外提供服务,应打开 "safety_check": {"level": "high"}。官方提供的是基础风控,审核输入和输出,命中风险时返回拒答标识。你仍然是内容安全审核的第一责任人,还要自行履行大模型登记、AI 标识等义务。
有一个实现上很容易漏掉的点:开启安全校验后,模型输出结束时连接不会马上关闭。服务端还会对完整输出再审一次,审核期间连接保持打开,之后仍可能变成拒答。流式界面如果已经把正文画上去了,收到 stop_reason: "refusal" 时,要用拒答文案把已展示的内容换掉,不能假定「已经输出的文字就是最终结果」。
输入命中审核会直接返回 400 Content Exists Risk。阅读链接时,未通过审核的网页会变成 url_not_allowed。
开启全家桶后,很多采样参数会被忽略
只要声明了联网工具、把 safety_check 设为 high,或打开了标题,下面这些参数改了也不会生效,以服务端为准:
max_tokens(Responses 里是 max_output_tokens)仍然有效,但它限制的是一轮中每一步推理的输出长度,不是整轮总长度。深度思考搜索会走很多步,按「整轮总上限」去设,会和实际行为对不上。
| 协议 | 被忽略的参数 |
|---|---|
| Messages | temperature、top_p、top_k、stop_sequences、thinking.budget_tokens、preserve_thinking、tool_choice.disable_parallel_tool_use、metadata(user_id 除外) |
| Responses | temperature、top_p、reasoning.summary、text.verbosity、include、max_tool_calls、truncation、metadata、parallel_tool_calls、store |
| Chat Completions | temperature、top_p、frequency_penalty、presence_penalty、stop、seed、n、preserve_thinking、parallel_tool_calls |
费用:Token 之外,还要按次算工具
对话本身按 Token 计费。以 deepseek-flash 为例,官方价格页按百万 Token 计价,并区分空闲和高峰、缓存命中和未命中。北京时间周一至周五(不含法定节假日)9:00–12:00、14:00–18:00 是高峰时段,其余时间含周末和法定节假日全天为空闲时段,空闲价是高峰价的一半。
联网、文件和语音是另计的。官方在 11 月 13 日的发布说明里放了这张工具价目图:
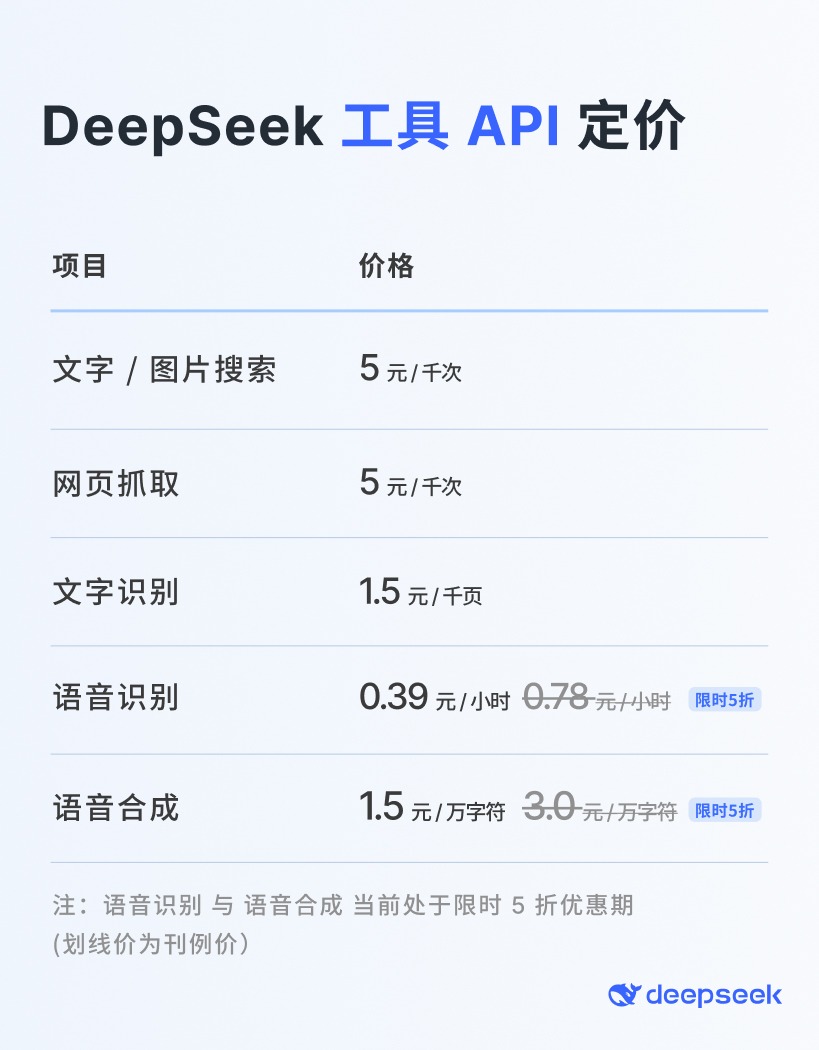
官方发布说明中的工具定价。图源:DeepSeek 发布全家桶应用 API。语音识别和语音合成在文档里标注为限时 5 折,请以当时价格页为准。
有几条计费规则,做产品时比价目本身更重要:
- 网页搜索按成功返回的查询词条数计费。一次调用里带了 3 个查询词,就计 3 次。失败或没有结果不计费。
- 图片搜索按图片张数计,模型框选区域时每个区域再计 1 次。
- 阅读链接按成功抓取的网页数计费;开启安全审核后,结果被替换成 url_not_allowed 或 unavailable 的也计费。完全抓取失败的不计费。
- 深度思考搜索里,打开网页只在真正从网络抓取时计费。再次打开同一页、在页内翻页、或打开内容已随搜索结果返回的页面,都不计费。页内查找不计费。
- 响应里的 web_search_requests、web_fetch_requests 是结果块数量,仅供展示,不是计费次数。计费次数看 tool_search、tool_fetch、tool_image_search。
- 会话标题不计费。
深度思考搜索一轮里可能搜索、打开页面多次。做对外产品时,最好在界面上让用户自己选择是否开启搜索和思考,并把这一轮的工具用量展示出来,避免「看起来只问了一句,账单却跳了好几次搜索」。
建议的实现顺序
- 先跑通官方演示。它已经覆盖了搜索、深度思考搜索、阅读链接、文件、安全审核、标题、语音、历史导入导出、Markdown 和 Mermaid。先看它怎么存消息、怎么画内容块,再决定要改哪些界面。
- 自己写时,先做流式渲染和历史回传,再做文件和语音。渲染管道不稳,后面的功能都会返工。
- 会话存储必须保存原始内容块,至少包括思考、工具调用、结果、kind、signature 和引用。不要只存纯文本。
- 对外服务把 API 调用放到服务端,打开 safety_check: high,并处理流式结束后的拒答。
- 超时按文档来设:文件解析要覆盖上传加解析;安全审核会在输出后再等一轮;标题最多再等 5 秒。
- 需要自己编排搜索、抓取时,再用独立的 Search / Fetch 接口。做 Chatbot,让服务端工具自己转即可。
哪些不必硬复刻
官方说的「1:1 复刻」,指的是对话能力对齐,不是把官方账号体系、云端历史和运营活动原样搬过来。演示客户端的数据只存在当前浏览器里,导出也不包含 API Key;上传到 API 的原始文件无法再下载回来。
也不必把界面做成官方面板的复制品。官方在发布说明末尾写过:现有对话产品只是较为基础的一种形态,他们更希望开发者省去重复的基础工作,去做更多样的产品。把内容块渲染对、把历史回传对,就已经站在同一套能力之上了;搜索质量、风控尺度、模型本身,本来就在服务端。
最后还要遵守开放平台服务协议。对外提供服务时,安全审核、大模型登记和 AI 标识,都是服务提供者自己的义务。